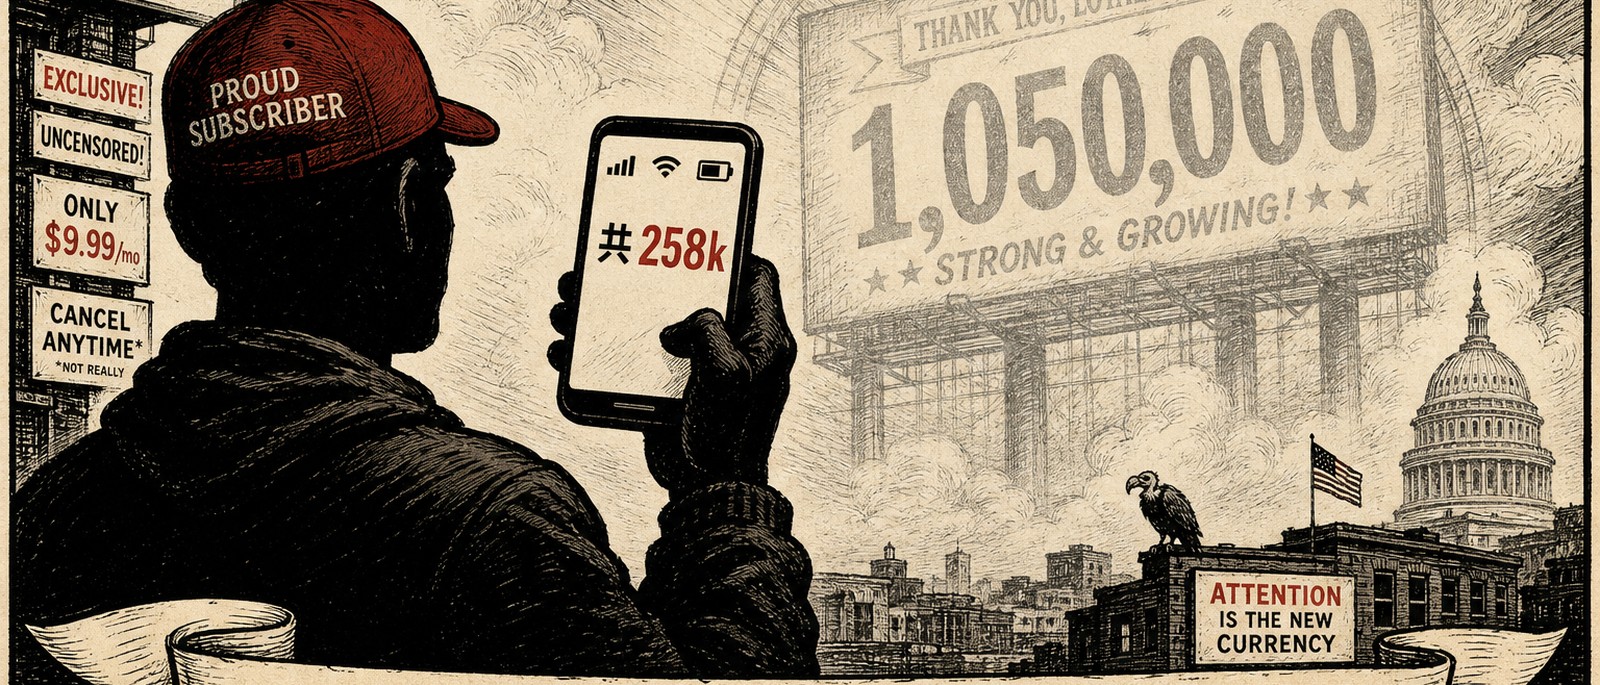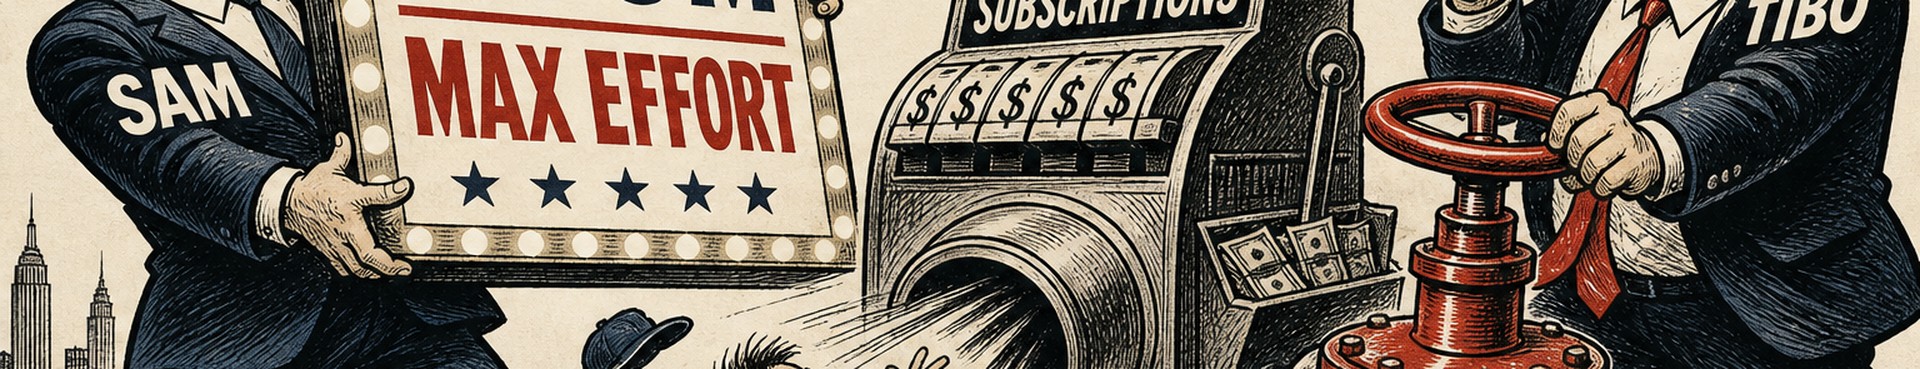
定性:营销诈骗(bait-and-switch / 信息不对等)——不等于法院刑事判决。题面「营销骗局」并存。
事实只出 brief-001 + brief-002。「刷」= 发布页 MRCR/Graphwalks 长窗分档公开打分(≠造假;≠所有 coding/agent 榜)。「最高 effort」= 发布页任意 effort 取最大值。
全网还在吹 GPT-6 Astra:百万上下文、能力表上的高分、Agent 能干完活。
钱你已经付了。Plus / Pro 扣过了。任务正跑到一半——仓库还在读、规则还在咬、进度条还在爬。
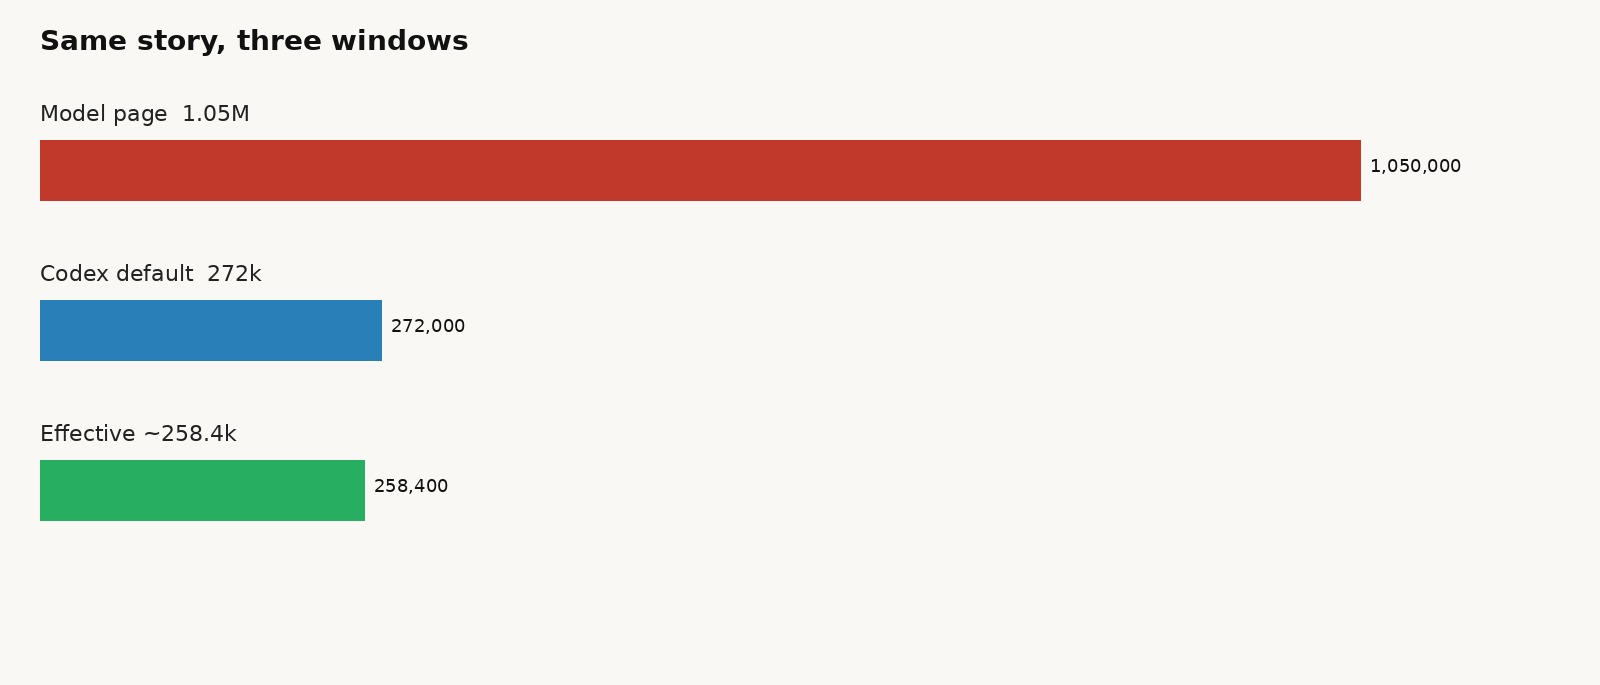
打开 Codex,状态栏却常常先亮:共 258k。
窗比任务先到顶。不是你不够努力,是收银台默认就把你按在大约规格窗的四分之一。
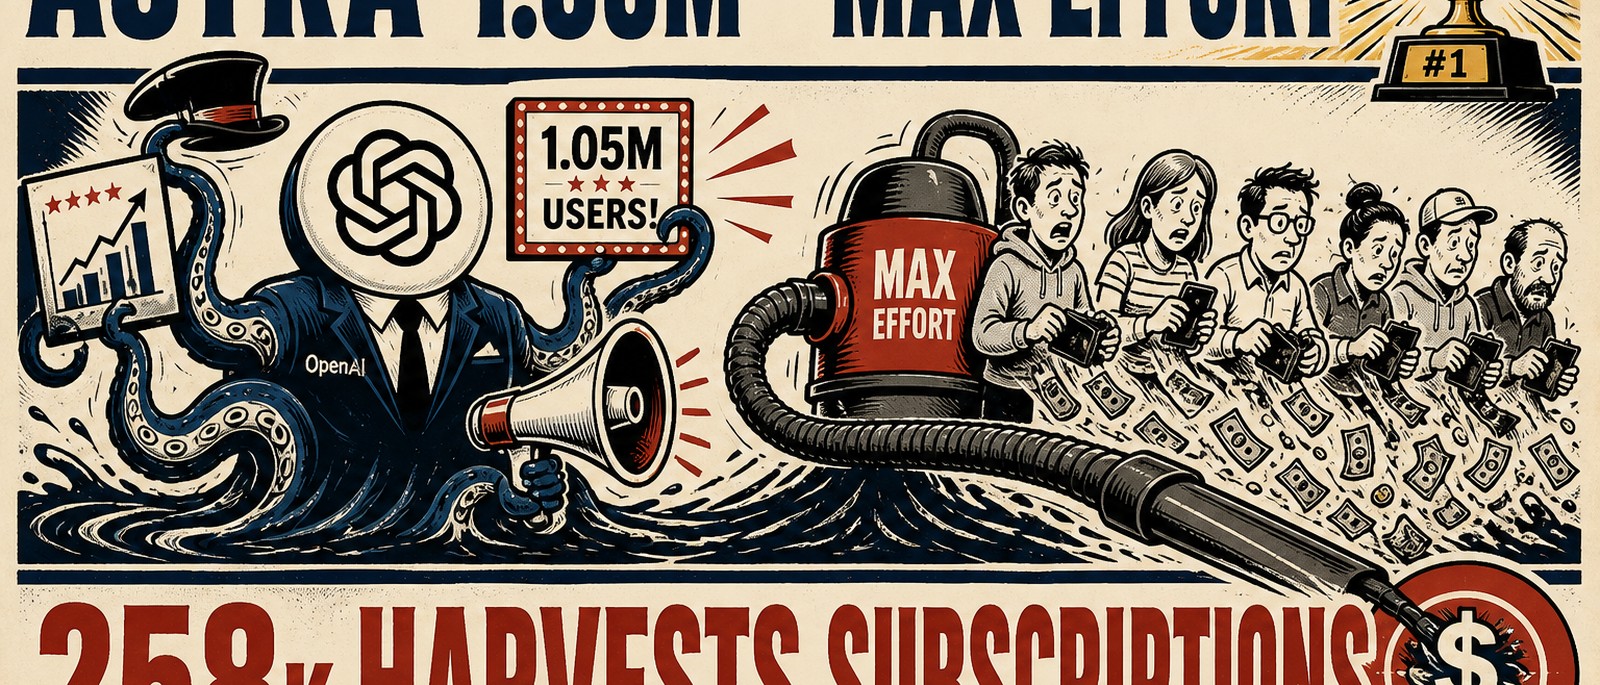
一边用 Astra 的百万上下文、再取最高 effort,去刷发布页那张长窗分档能力榜(MRCR / Graphwalks);一边用大约 258k 收割订阅。
你订阅到底买到了哪一档能力?
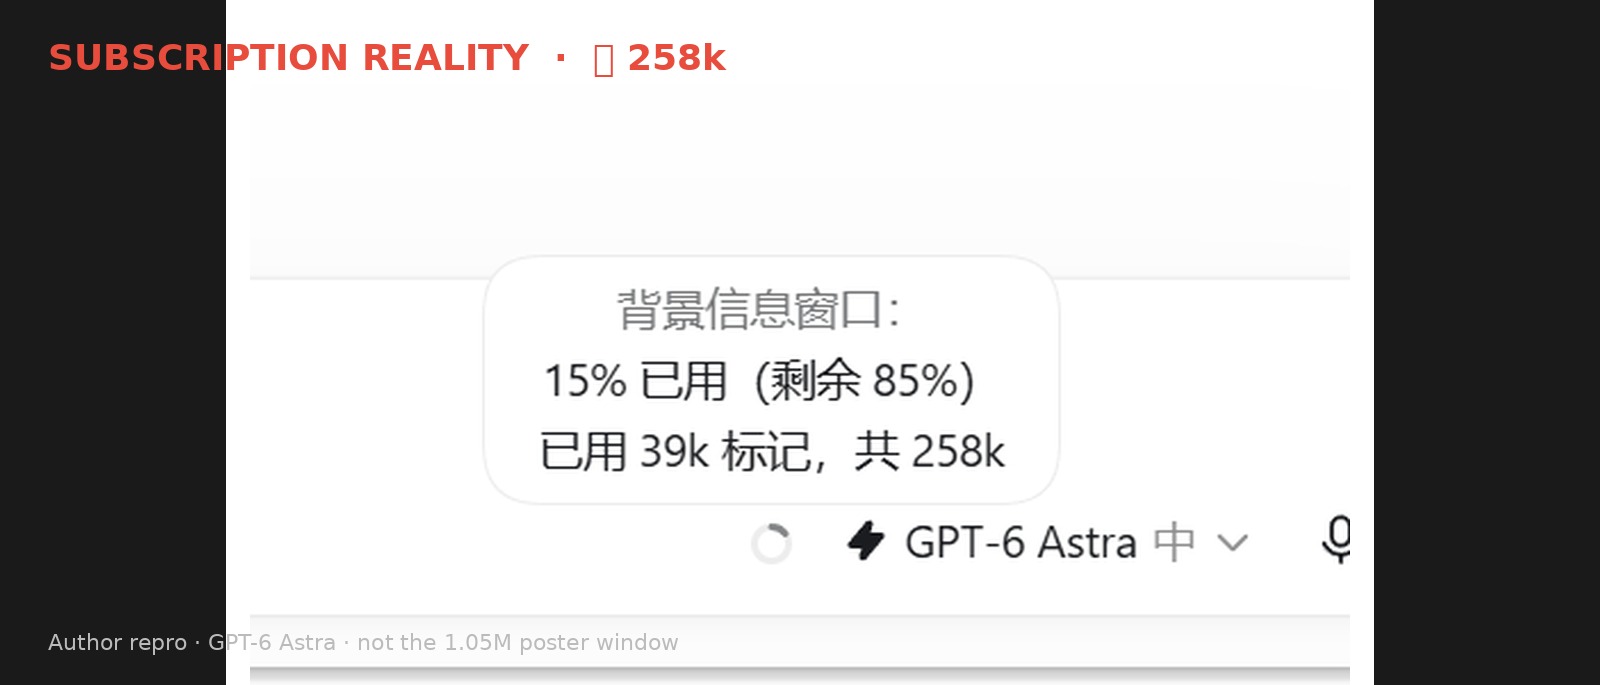
出口: 先抬头看自己的「共 xxxk」。对上了,再往下读。
下一刀先不讲课:对外他们怎么喊算力。
2026-08-18 PT,@ClaudeDevs 谈周限加成与容量压力。同日深夜,Tibo(@thsottiaux)回了一句:
@ClaudeDevs Do not worry, we have compute
(https://x.com/thsottiaux/status/2089964604172673121)
中文:别担心,我们有算力。
这不是 9/3 故障旁白——原帖早约两周,回的是 Anthropic 额度/容量帖。六个英文单词,对外算力战书,挖墙脚都嫌短。
对内呢?同一个人、同一条产品线:
Codex 订阅路径上,默认常见 ~258k(catalog 默认 context_window: 272000,有效常按 ×95%)。
默认窗被一手写成按 performance and cost 调优,还叮嘱 tuned the default carefully。(https://x.com/thsottiaux/status/2089082893804896524)
更刺的是 2026-07-12:产品窗抬到 372k 之后,more usage being charged than intended——用量扣得比他们打算的更凶——于是公开打回 272k,并告诉你用量会明显少烧。(https://x.com/thsottiaux/status/2076495156757577895)
把两张嘴拼上:对着对手喊 we have compute;对着付费用户,窗为 cost 拧紧,抬高了还因「扣太多」打回去。
屈辱感就在这儿——不是客服口误,是同一张脸的两套台词。性质怎么钉,放到账算清之后;先把这张脸记住。
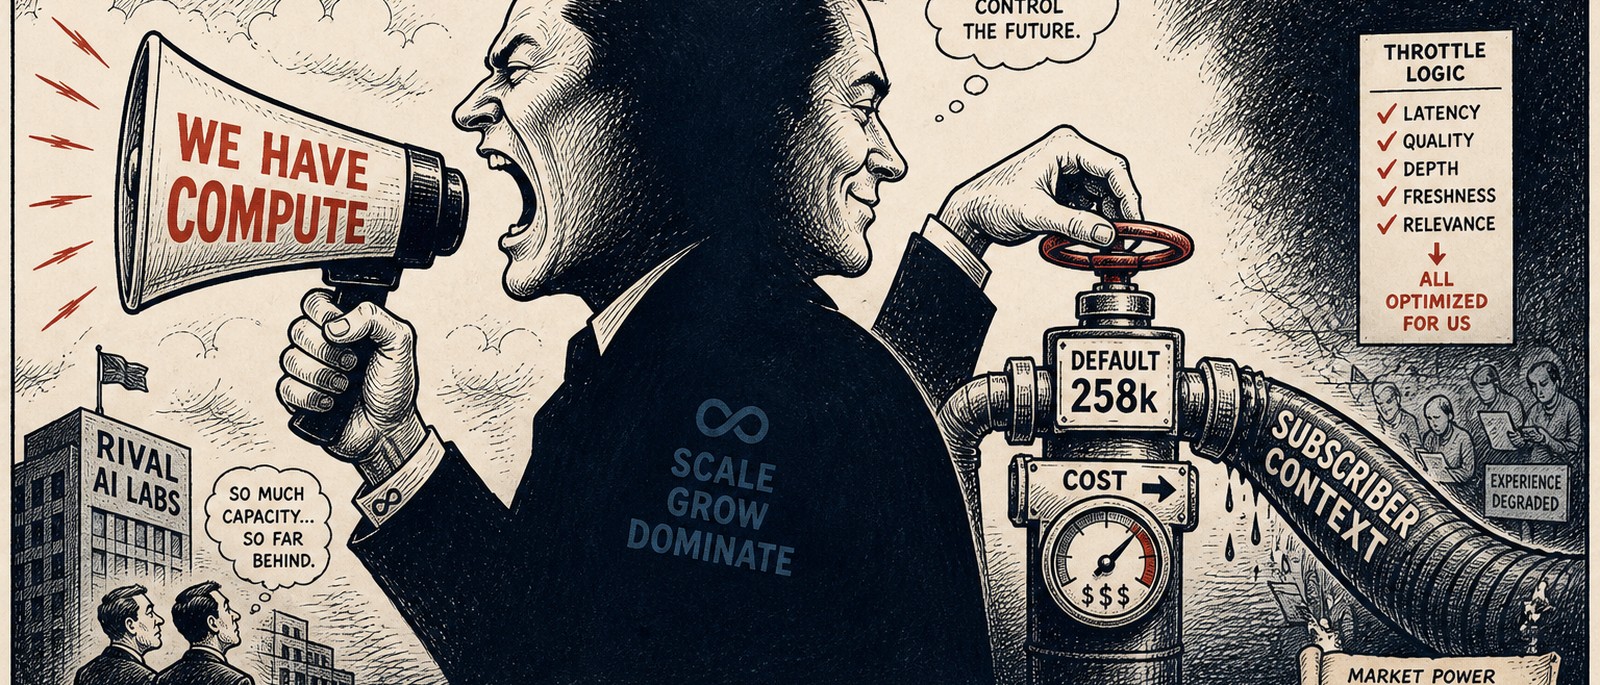
讽刺画旁挂原帖,不作截图伪造。
出口: 「we have compute」跟你的状态栏截一张并排——对照/对账,发不发随你。
觉得屈辱?下一章更疼:任务做到一半,记忆先死。
有人会说:默认约 258k 没关系,压一压、摘要一下就等于百万上下文。
先不辩理论。看 258k 现实:
OpenAI 自己在 Astra 发布文里写过:历史上用 compaction 摘要时,Each compaction can leave out details about why a fix failed or how a component behaves.——然后推销跨窗 notes。方向同用户报告一致:官方承认旧摘要压缩会漏细节。 Tibo compaction 专论——本包未找到。
在百万上下文工作点一次跑完 ≠ 默认约 258k + 有损摘要。
notes 是缓解叙事;订阅默认窗问题还在。
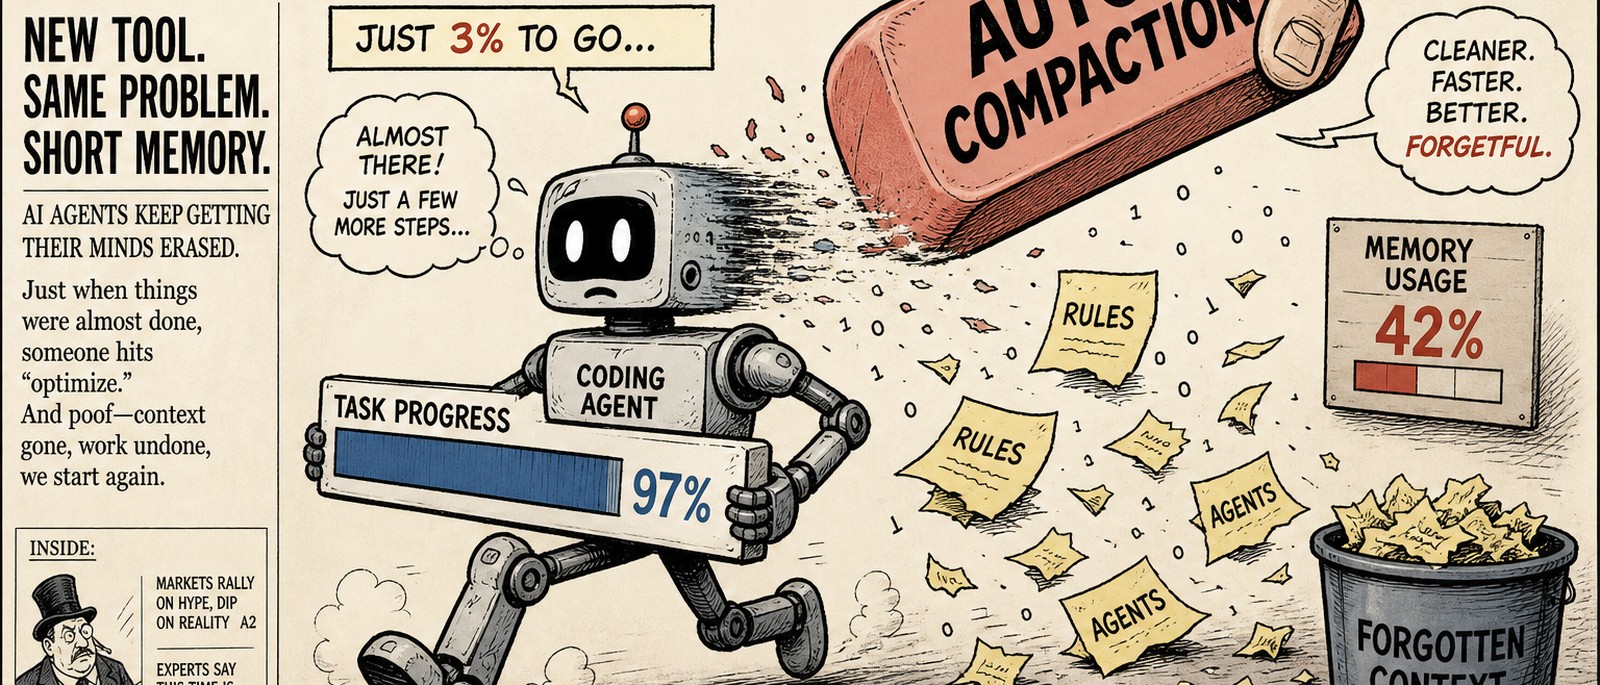
出口: 晒你的压缩失忆、进度跳水、abort——比争论「压缩理论」更能续命。
痛过了,再看海报上的「强」到底绑在哪。
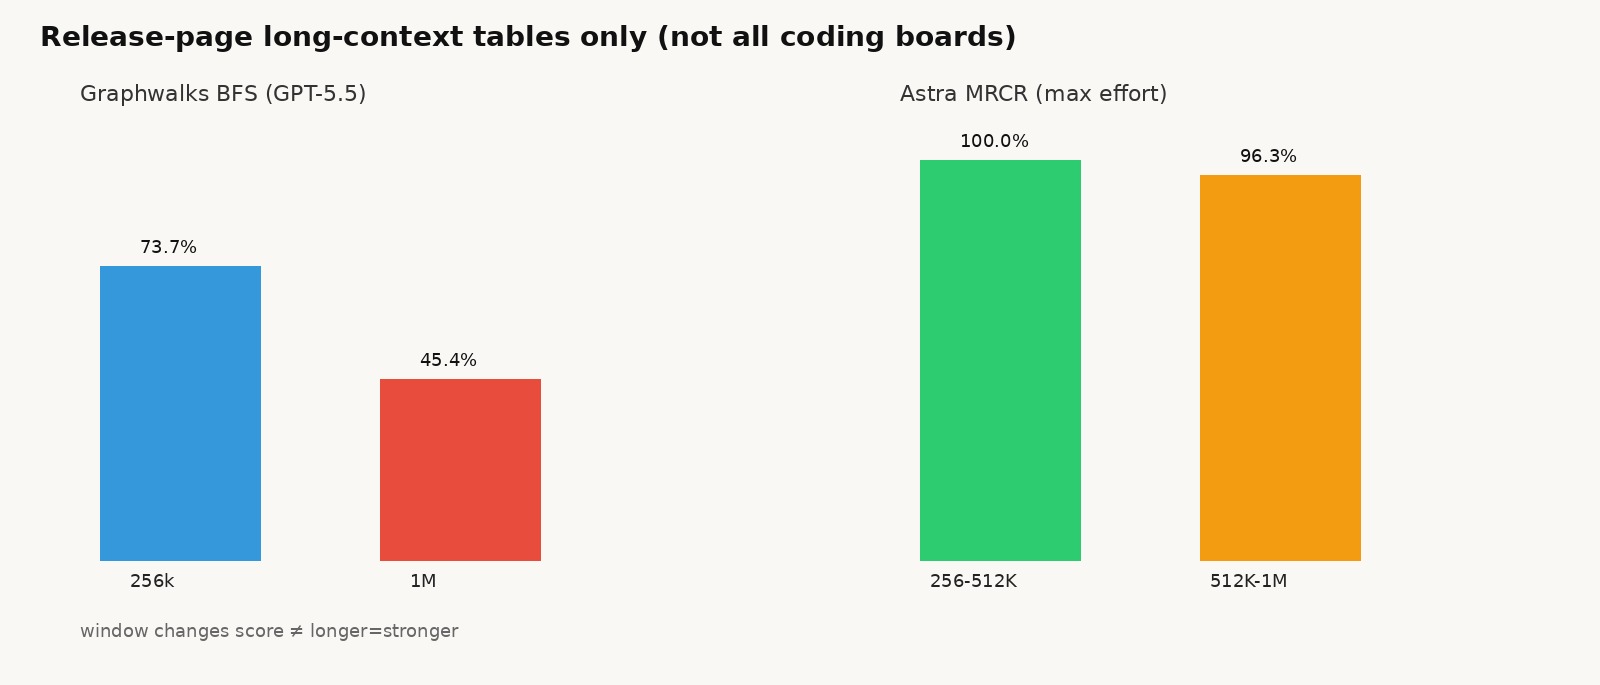
OpenAI 发布页把长上下文能力写成硬表,而且按长度分档打分。
Astra 发布页把长上下文写成按长度分档的成绩单;页脚写明分数取任意 effort 的最大值——题面「最高 effort」「刷能力榜单」锚在这里:规则内取峰值,不是造假刷分。(https://openai.com/index/gpt-6-astra/)
具体分档数字进表图(05):正文只记结论——MRCR / Graphwalks 这类长窗分档表才是本文说的「能力榜单」;5.5 / 5.6 家族页同一玩法。
另一面:Terminal-Bench、DeepSWE、Agents' Last Exam、OSWorld 一类 coding / agent 榜——多数找不到「该次评测 context = xxxK」原文。模型页能写规格 1,050,000;找不到「SWE/agent 在订阅默认窗跑」的对照声明。
长窗分档表有硬数字;订阅默认工作点,没进同一张表。
不能滑成「所有 coding/agent 榜都在百万上下文上刷」。
出口: 海报工作点,真是你这条 Codex 线程吗?
下一算:砍到约四分之一,分数怎么变。
算术很粗暴:约 258k ≈ 1.05M 的 ~1/4。bundled catalog 默认 context_window: 272000(有效常 ×95% → 258400),max 872000 是上限,默认不抬。
官方同模型、不同长度,分数会变——表图 05 用两根柱子就够:Graphwalks 从 256k 到 1M 掉分;Astra MRCR 长窗档仍高。
先钉结论:窗长一变,分数就变——不是「越长越强」。 MRCR 高分是海报卖点;Graphwalks 提醒你别把「百万上下文」自动翻译成「处处更强」。完整数在图里,不在这里复读。
这些都不是「同一 Codex 多步 agent 在 ~258k vs ~1M 的完成率对照」。那种对照——公开对比稀缺。禁止编「差 75%」「只剩两成」。
机制层能写:默认更短 → 更早撞窗 → 更勤有损压缩 → 约束与轨迹更容易丢。
(完整分档见上表图 04/05;正文不重复砸数)
出口: 别问聪不聪明;问你付费会话停在哪一档上下文。
那他们为什么还要这样卖?
三问——证据分层,不装内鬼。
更好用?
产品侧爱说 default tuned carefully / to ~perfection,夹带 performance。可当自述;单凭此证明不了「258k 对你一定更好」。
更省钱?——钉得最死。
Tibo 一手:默认窗为 performance and cost 调优。(https://x.com/thsottiaux/status/2089082893804896524)
372k 打回 272k:用量扣超预期,公开说明 revert。(见 §1)
API:Astra/Sol 页写明输入超过约 272K,整笔 2× / 1.5× 一类溢价——长上下文被标成贵商品。
全员默认百万上下文跟不上?
行业 KV cache 随长度与并发吃显存(NVIDIA / Hugging Face,非 OpenAI 账单)。自家又设溢价门槛。机制推论可写;禁止写成内部算力报表。
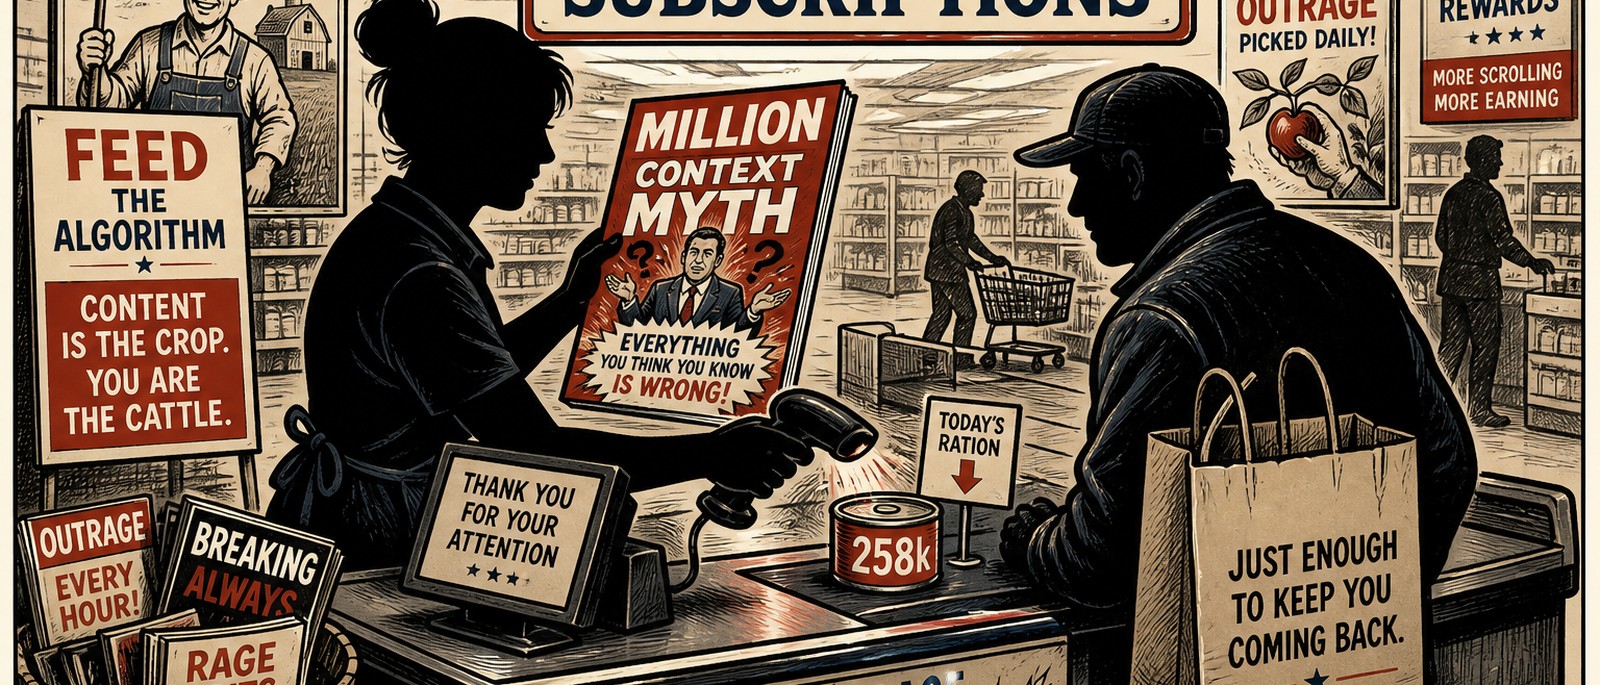
测得起、写得进规格、在长窗分档表上刷出高分;订阅默认拧在 cost / 用量上。
百万上下文神话收割订阅;默认约 258k 控烧钱。
出口: 「为体验调优」——调的是你的任务,还是他们的账单?
账听懂了,定性钉死。
挂羊头卖狗肉:规格与发布页长窗分档叙事卖百万上下文神话;订阅收银台钉默认约 258k。
这就是营销诈骗——bait-and-switch / 信息不对等。
题面那句最无耻的营销骗局,指的就是这个结构。
不等于法院刑事判决。
旁刀一句(主刀仍砍 OpenAI):同样谈算力压力,Anthropic 更常把 SpaceX / Colossus 扩容写进官方文,并公开调额度——包括临时 +50%、再「永久 +25%」、澄清相对今天约 −17%(一手帖见 brief-001)。OpenAI Codex 路径上更醒目的是长窗分档叙事 + 默认约 258k + 对外 we have compute。不洗谁更厚道;只问谁让你更清楚「订阅买到什么」。
出口: 定性有了。下一刀怀疑空气——为什么还有人尬吹。
Tibo 一手里程碑 reset:过 10M 沉默后再宣布 15M / 20M / 25M reset……体感「被宠」;active users 口径未披露。(evidence/tibo-milestone-reset-posts.json)
OpenAI 停报 SWE-bench Verified;另估 SWE-Bench Pro 约 ~30% tasks broken。方法论文提醒:发布帖里的分数常常是 model + scaffold + 环境 + 预算,不是裸模型分。
并排现象,不捏造部门:发布页长窗分档刷分 + reset 表演 + 状态栏默认约 258k。
通过订阅,你到底得到了哪档能力?
那张长窗能力榜单(以及别的 scaffold 分)是不是深度营销?你是不是也被带着吹过?
出口: 晒「共 xxxk」——顺便承认一句:我也被榜单带着吹过。
账对完了,别停在吐槽窗长。
更大的事是:当「能力」主要靠发布页与榜单被看见,而「订阅实得」要靠你自己翻状态栏才发现,行业事实上在训练一种习惯——先相信神话,再慢慢适应缩水。
这不只是 Codex 一家的产品细节。它碰的是人机协作的契约:你把月费、工作流、甚至判断外包出去,换来的究竟是可核对的能力,还是不可核对的叙事?若默认路径长期信息不对等,Agent 越强,不对等的伤害越大——因为任务更长、依赖更深,窗一到顶、记忆一压缩,付出的是真实工期与信任。
行业道德在这里很具体,不玄乎:
人类与 AI 的未来,不会毁在模型「不够聪明」,更容易毁在聪明人假装你买到了另一档智能。信任一旦变成「先付费,后对账」,下一轮升级叙事会更轻、用户会更钝——钝到不再追问「我订阅到底买到哪一档能力」。
所以收束不只是骂一骂。是把标准抬高一寸:
要神话,也要可对账的实得。
要 Agent 未来,先要诚实的默认窗。
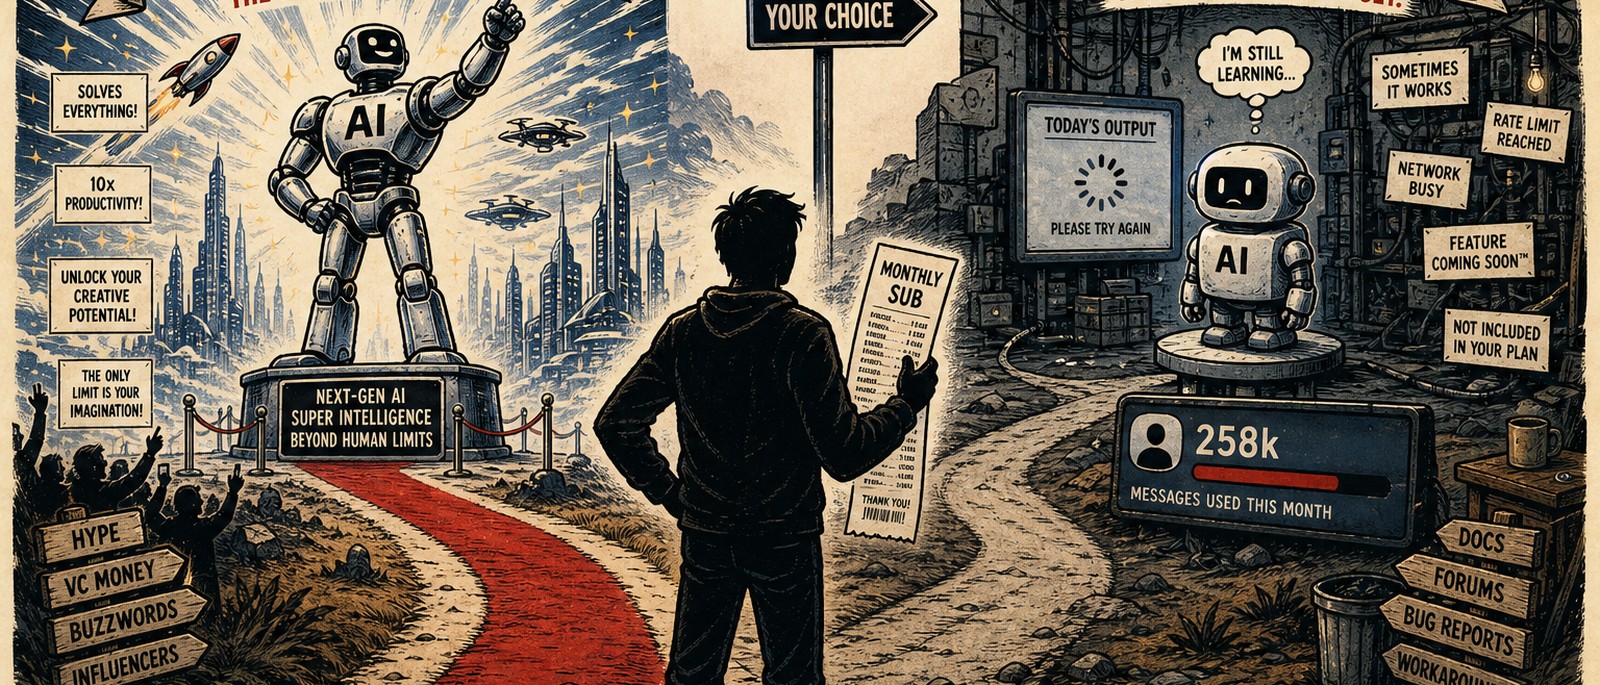
钱付了。任务跑了。窗先到顶。
打开 Codex,再看一眼「共 xxxk」——然后决定,你还愿不愿意把下一段人机协作,建立在同一套不对等上。
这就是营销诈骗(题面:最无耻的营销骗局)。
≠ 刑事——但作为公共讨论的底线,账与未来,都该对得上。