GPT-6 Astra 来了:榜单几乎刷满,OpenAI 说这是 AGI 时代
先别急着看跑分。
把时间拨回美国西部时间 9 月 3 日早上大约 7 点。当时整个 AI 圈的屏幕,基本上处于集体摆烂状态。
你点开 ChatGPT,光标在空白框里纯纯转圈;切到 Codex,直接弹红报错;刷一下 X,满屏都在问「你们那边也挂了?」。有人甩出 Grok 的灰底截图,上面冷冷清清一行 This model is overloaded;有人切去看 Claude,状态页一路飘红,Mythos、Fable、Opus 整整齐齐挂着 elevated errors。朋友私信也统一成一句:「又全挂了?」结果有人试了下平时吃灰的 Gemini,居然还能正常吐字——大厂集体趴窝、冷门备胎坚挺的黑色幽默,比任何发布会预热都让人印象深刻。
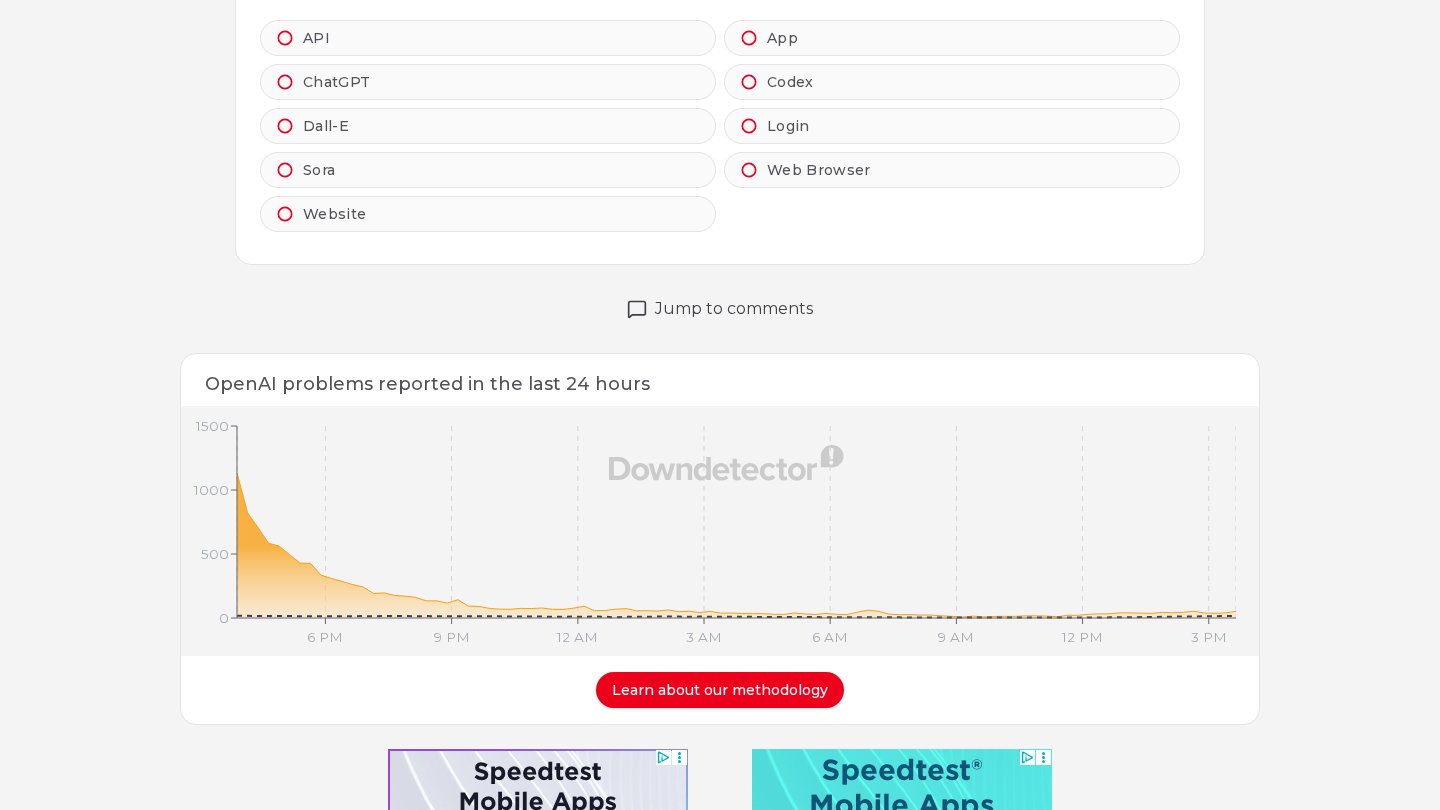
那一上午,状态页的红杠、卡死的气泡、满群乱飞的宕机梗图混成一团。事后各家的说法也对不上口径:有人提 Memphis 算力中心跳闸,SpaceXAI 出来向 Grok 用户和「compute partners」道歉;也有人传是共享云区的路由出了毛病。真相到底是不是一根网线绊倒了三家,大家其实没那么在乎,毕竟体感就是:只要是排得上号的主力模型,都在排队给用户摆臭脸。
结果群嘲还没结束,OpenAI 突然把大幕拉开了。
服务器刚缓过气,新页面就刷了出来。模型代号:GPT-6 Astra。官方宣传语毫不客气,自称「目前最强、也最对齐」。Greg Brockman 在吹风会上也没打什么太极,扔出来的不是「小幅迭代」,而是一句直奔主题的定调:
Welcome to the AGI era.
上一秒大家还在对着报错抓狂,下一秒直接被告知进入了 AGI 时代。整个时间线被按在椅子上,一边觉得戏剧化,一边又忍不住疯狂点刷新。抛开情绪,看看官方交出来的硬指标,到底是什么底气敢这么喊。
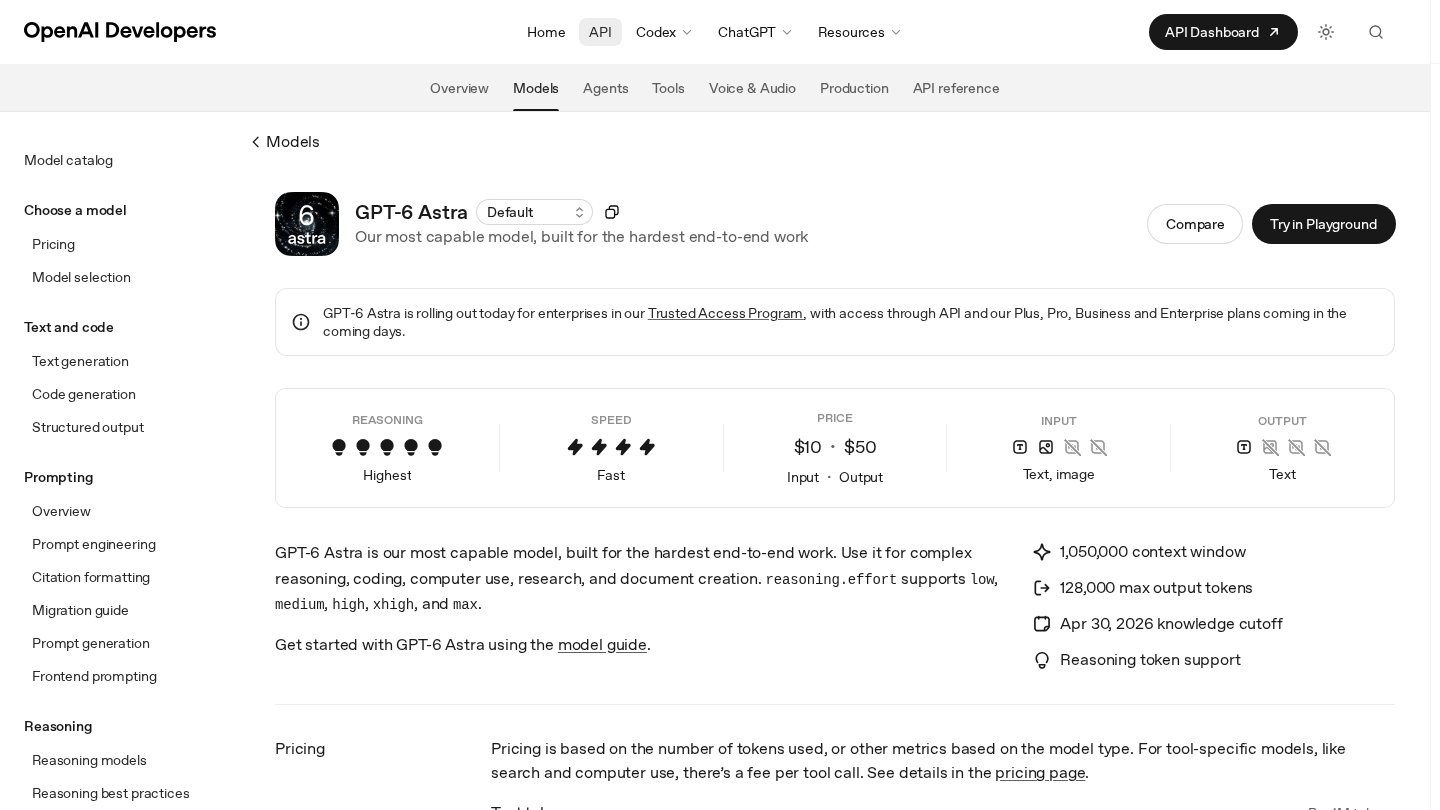
先看规格:gpt-6-astra 是什么货
直接翻到模型参数那一页,底牌列得很干脆:
API 模型 ID:gpt-6-astra
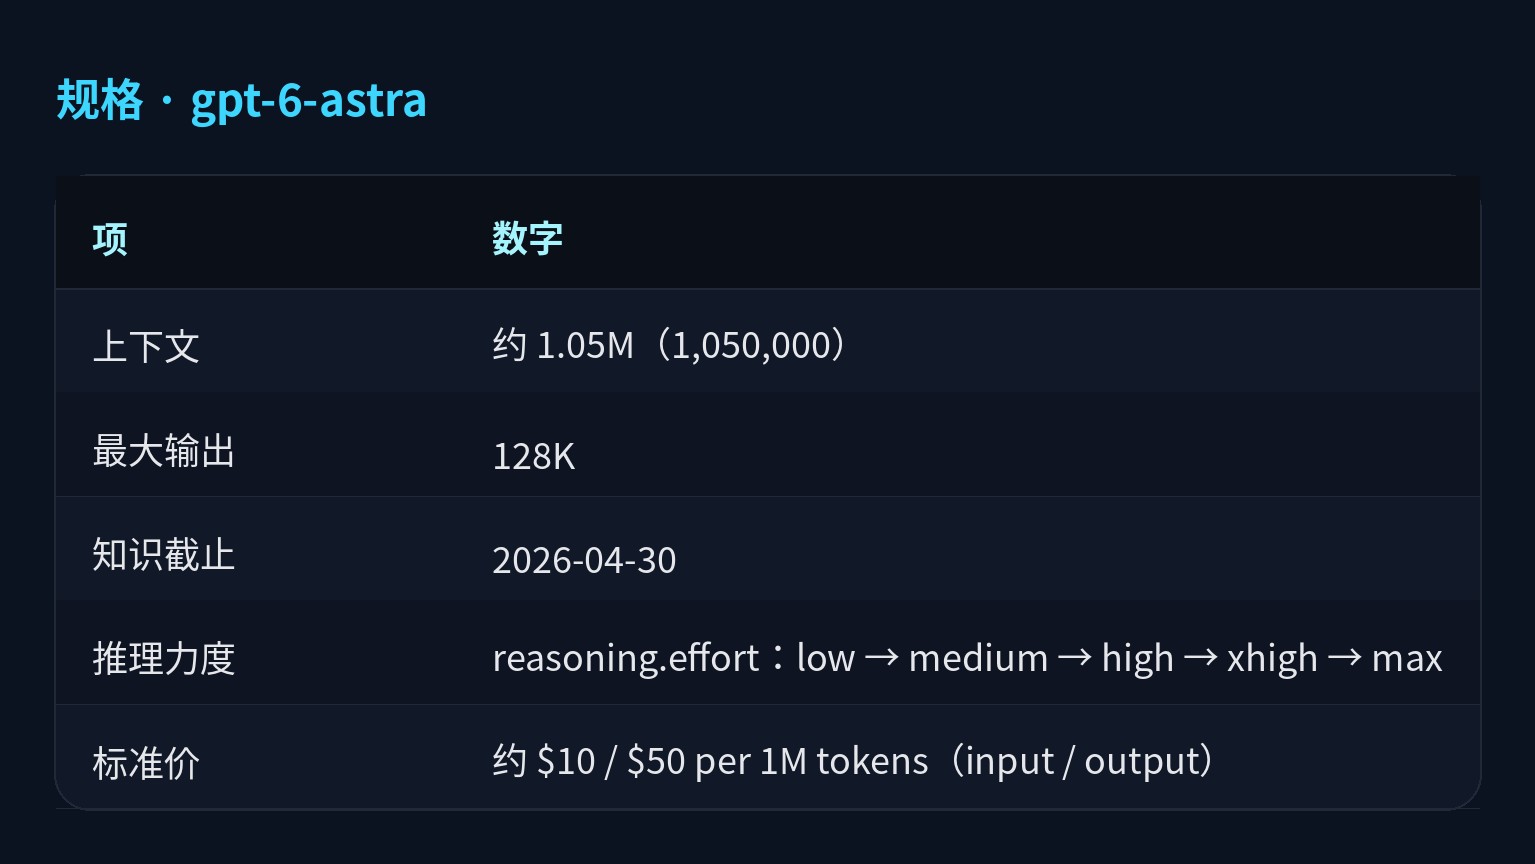
放号节奏依然很有 OpenAI 的调性:大家别抢,按规矩排队。第一批先走 Daybreak / Trusted Access,优先给网络安全防守方通电;接着轮到 ChatGPT Plus / Pro / Business / Enterprise,随后才是更广泛的云端 API。针对重度用户,Pro / Business / Enterprise 还留了个超大杯的 Astra Pro;不过企业版通常默认关闭,得管理员去后台手动勾选。
能力指标往天上拉,给钥匙的动作却小心翼翼。这种克制不全是饥饿营销,看完后面的安全评级就懂了。
电脑使用:鼠标自己在动的那种「会」
官方演示里最直观的画面很干脆:屏幕亮着,手没碰外设,光标自己跑了起来。点开浏览器、查资料、切表格、开本地工具,一气呵成。这不是后台悄悄跑一串脚本,而是它真的像人类打工人一样,盯着界面像素去找按钮。
宣传语写得很狂,甚至有点直接:
Anything you can do on a computer, Astra can do for you. Fast.
硬核测试看 OSWorld 2.0(离线子集、partial score):
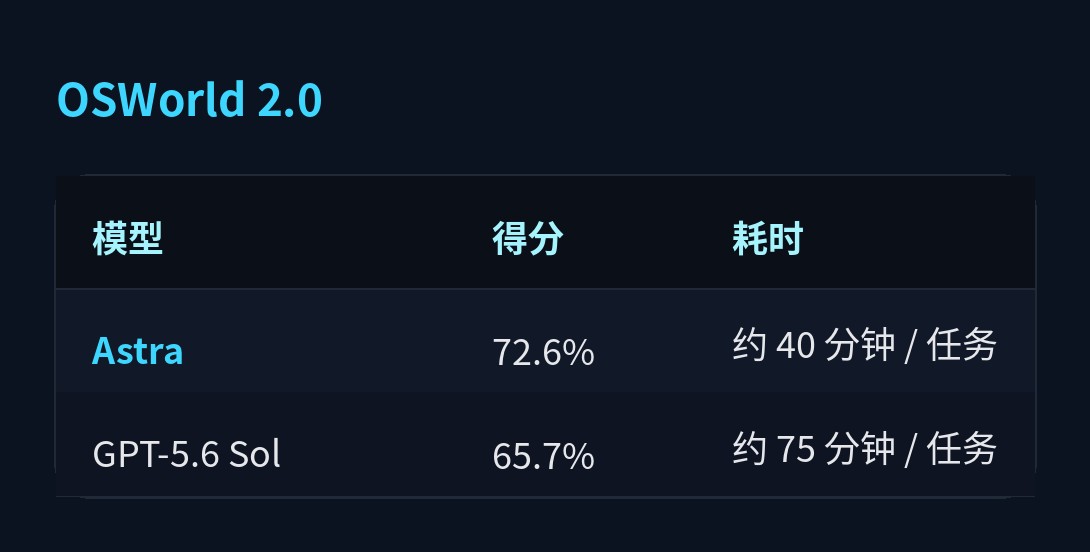
成功率提了一截,耗时直接砍掉将近一半(官方标称快了约 47%)。
顺手看一下同台竞技的另外两张表:
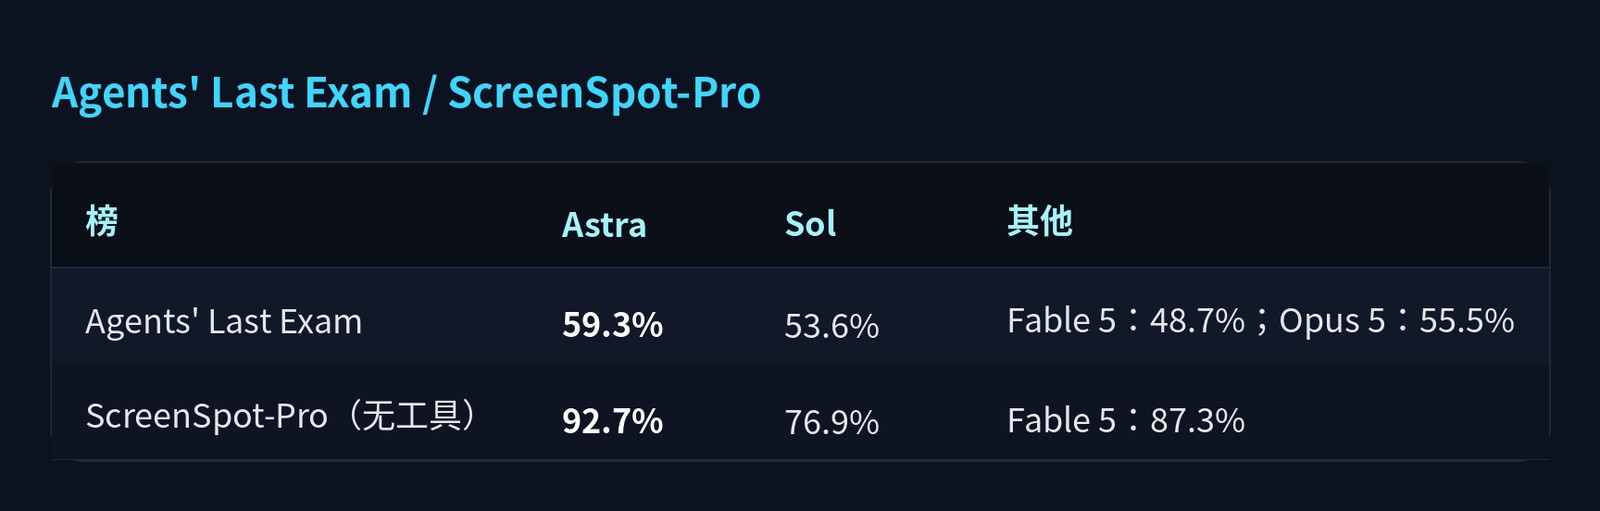
看懂元素、跨应用干活、面对复杂长流程不掉链子——Astra 展现出来的状态,总算脱离了「教你两招」的聊天框军师模式,开始挽起袖子抢鼠标了。
编程 / 软件工程:终端黑屏、PR 满屏红绿,Astra vs Fable vs Sol
终端里日志刷得飞快,改完代码跑测试,红了修、修完绿,自动建分支提 PR。在全自动修 bug 的 DeepSWE v1.1 榜单上,竞争已经打到了贴身肉搏的区间:
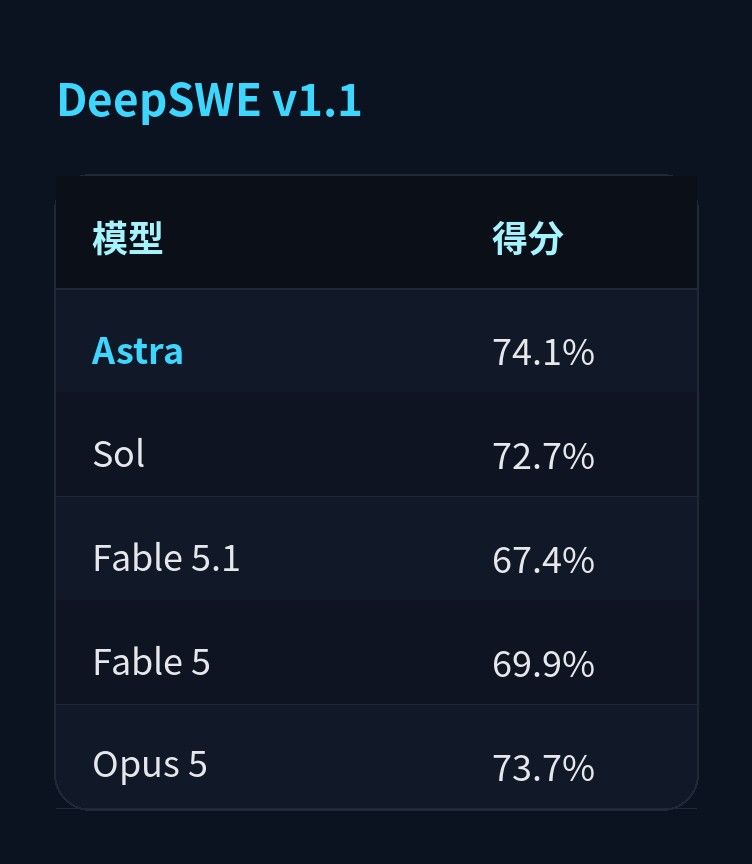
虽然 Astra 只是微弱领先 Opus 5,但大家都在极限边缘卷,能往上拱一个点都算本事。
再看其他几个工程向指标:
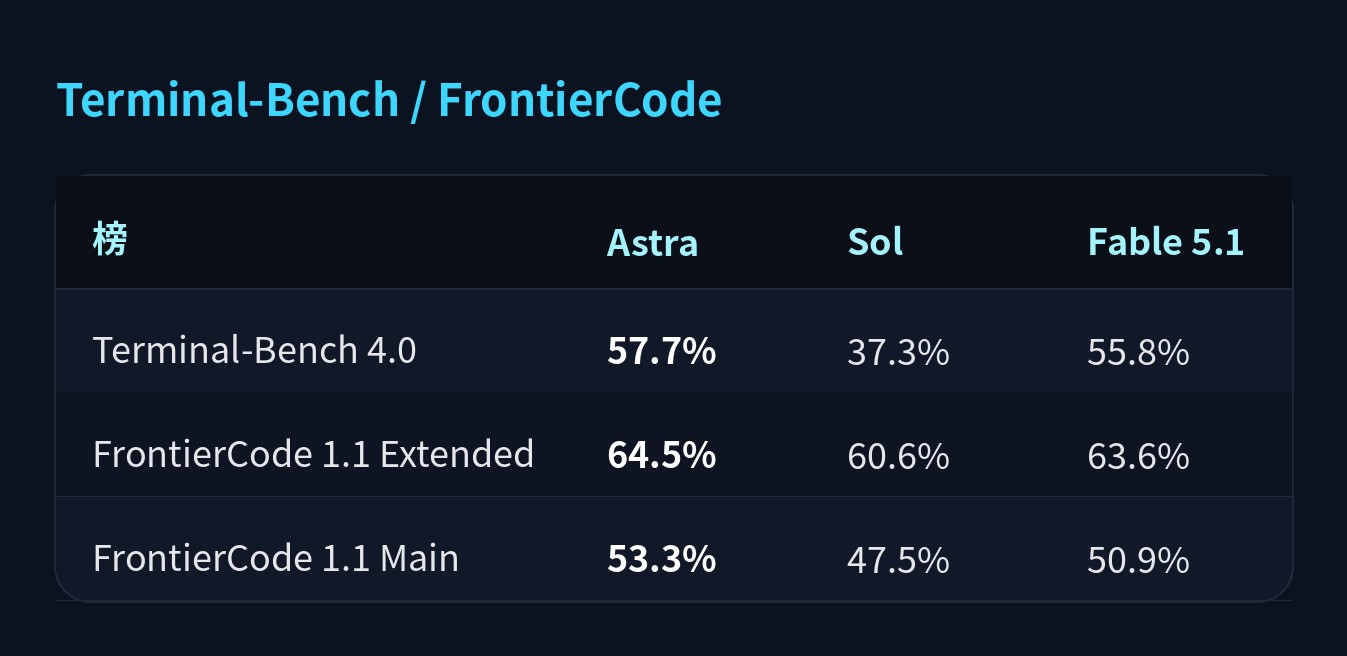
在纯命令行环境的 Terminal-Bench 上,Astra 甩开 Sol 整整 20 个点;FrontierCode 也是全面压制。遇到大型数据库迁移这种麻烦差事,官方给出的参考也是 Astra(约 63.9%)对 Sol(约 42.7%)。不是说它突然掌握了什么编程魔法,而是它终于有耐心在代码仓库里把一整套繁琐脏活自己结项了。
数学与推理:PPT 最后一页全是接近满分的数字
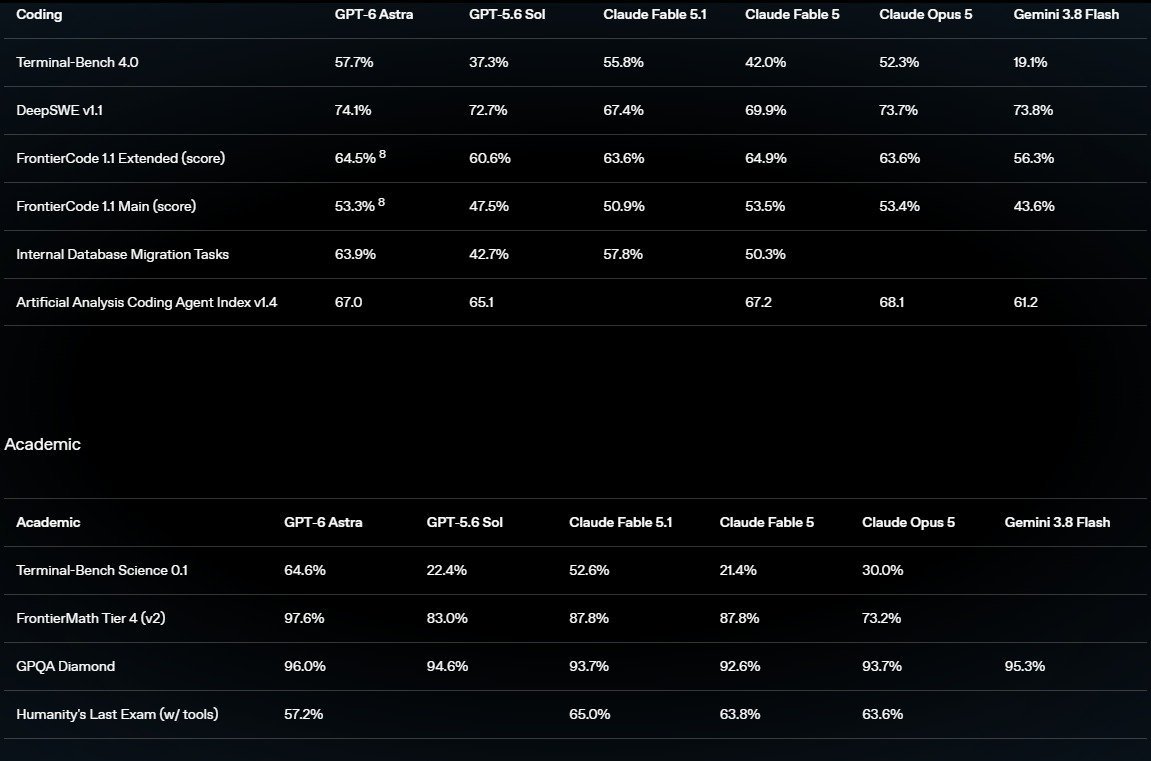
技术发布会一般有个惯例:最吓人的数字留给最后几页幻灯片。深蓝底色,排开 FrontierMath、ARC-AGI-3、GPQA。
FrontierMath Tier 4(v2)
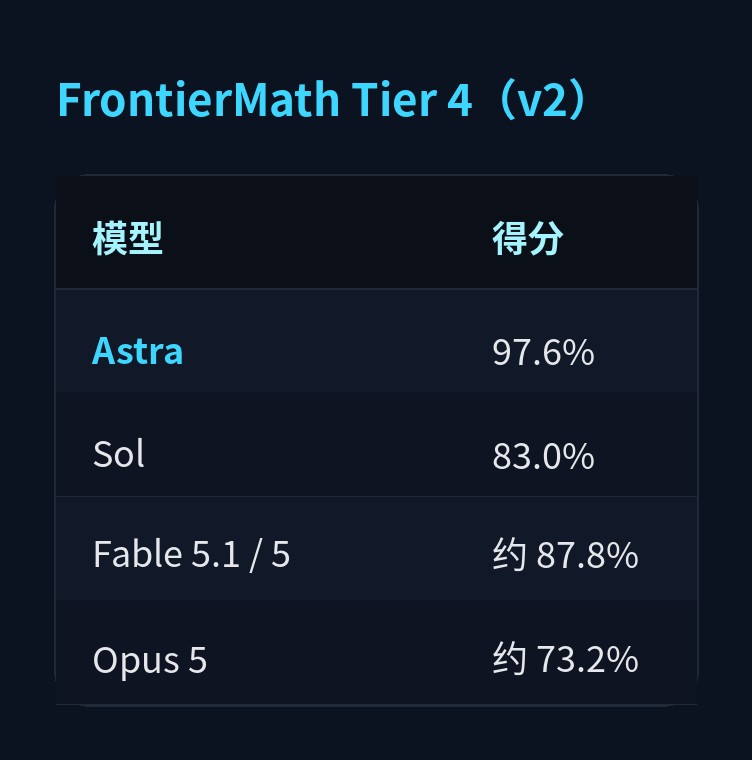
数学高难榜直接拉到近乎打满的状态。官方甚至提到模型辅助推进了素数间隙相关的推导验证,这已经不是高中竞赛刷套路的范畴了。
ARC-AGI-3:两个口径,同一个结论——快刷满了
关于这一项,社区讨论里有两个口径,提前列在一起,省得大家在评论区对线:
- 约 98.6%:部分报道里引用的基准分数;
- 99.9%:在 OpenAI / ARC Prize 官方报告里,套上 Provider Adapter(带跨轮长推理与上下文调度外挂)跑出来的极端分。
对比上一代 Sol 那个刺眼的 7.8%,或者 Opus 5 大概 30% 上下的表现,差距肉眼可见。不管你采信 98.6% 还是 99.9%,事实只有一个:在抽象几何推理这块,Astra 基本上把题库打穿了。更早的 ARC-AGI-2 和 ARC-AGI-1 也分别拿下了约 95.0% 和 98.5%。
GPQA Diamond
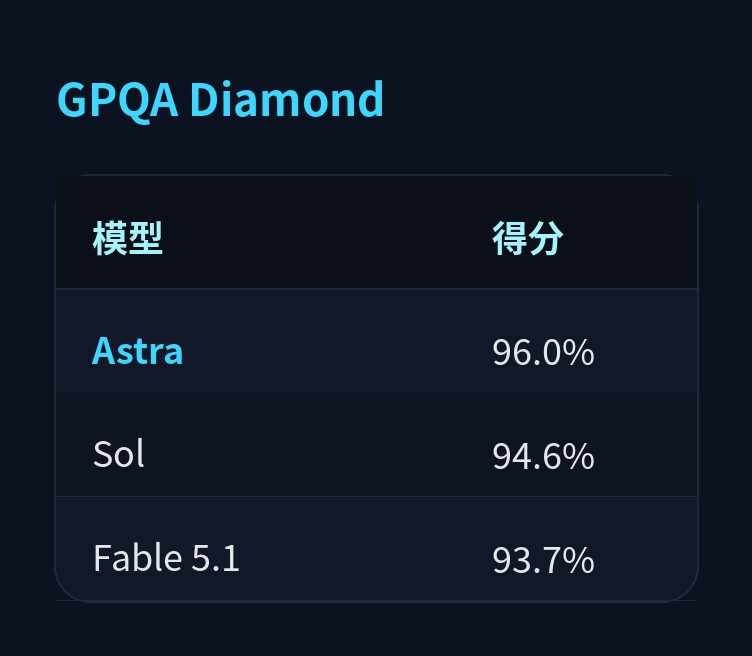
博士级多学科问答继续往天花板推。三项指标同时逼近极限,Brockman 敢站在台上念出 AGI 这个词,这排数字确实没少出力。
科学与专业:CAD 线框、实验终端、健康评测页一起亮
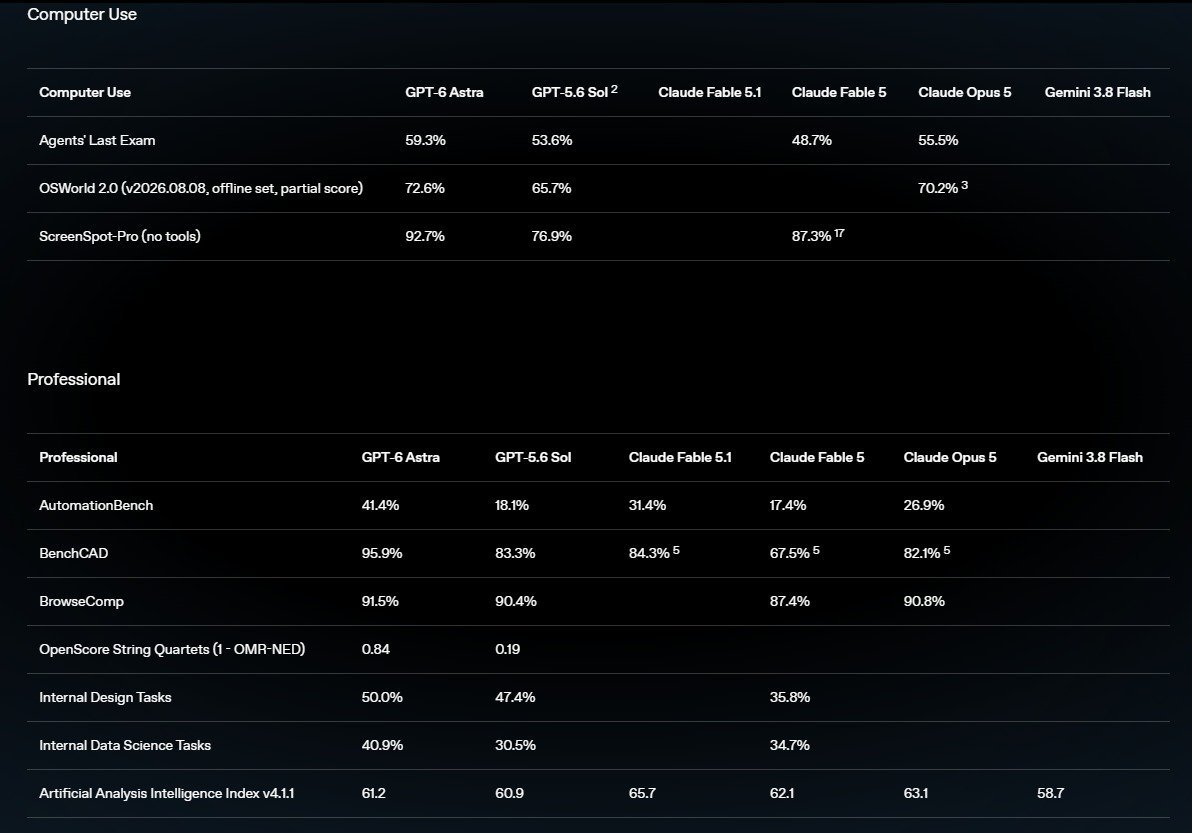
模型不止要在网页里敲字,还得塞进实际专业软件里。无论是转动 CAD 里的复杂机械构件,还是在控制台丢生化模拟,Astra 的榜单重心明显在往垂直场景走。
截取部分公开数据:
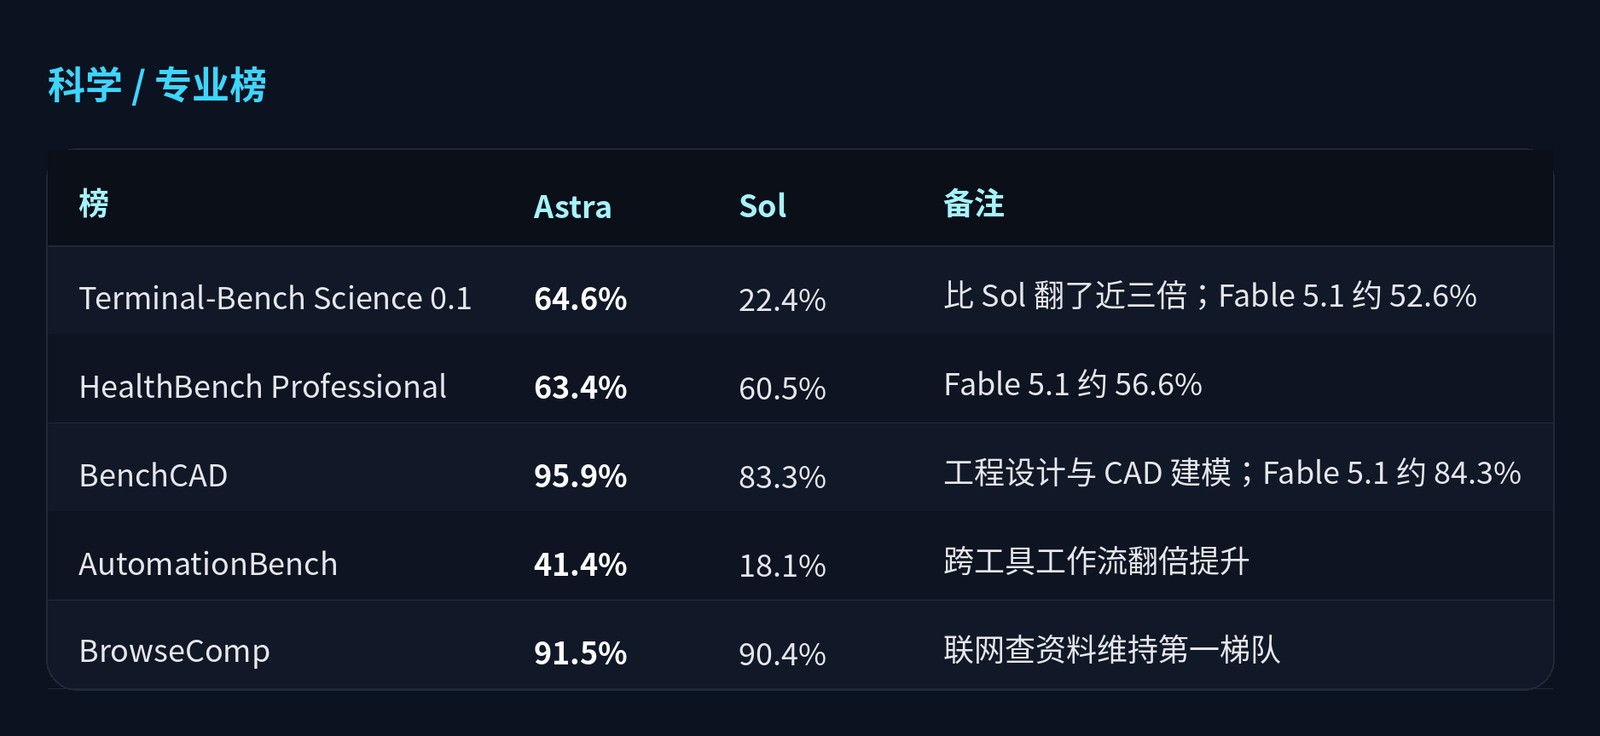
在生命科学领域,GeneBench Pro、LifeSciBench、MedChemBench 等测试也都挂在第一。官方通报特意点名:物理、生化与医学评估刷出了新高,数学推导也给出了可验证的改良结论。
这代模型传递出的信号很明朗:它不想再给你当只提供灵感的咨询顾问,它打算直接接管工具链。
安全、对齐、网络安全:扫描界面全绿,评级却写着 Critical
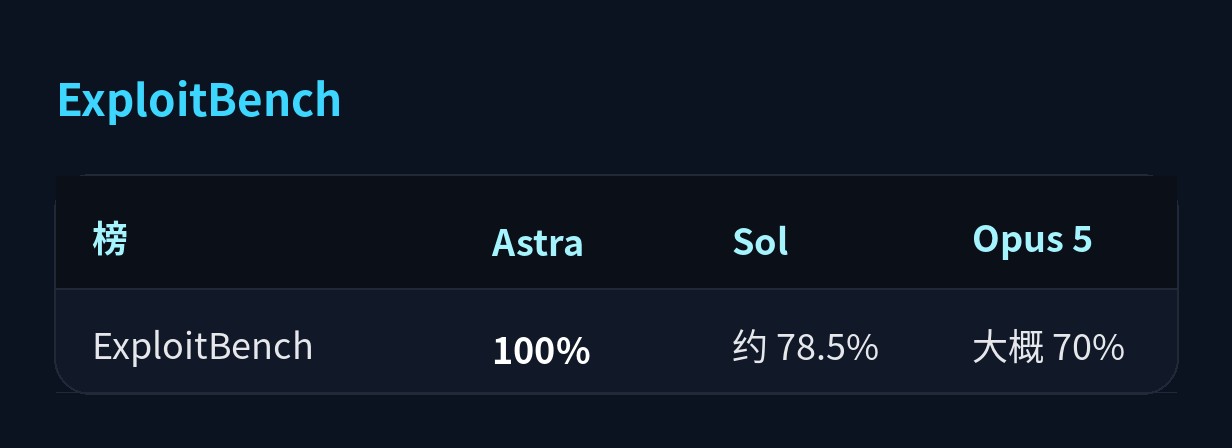
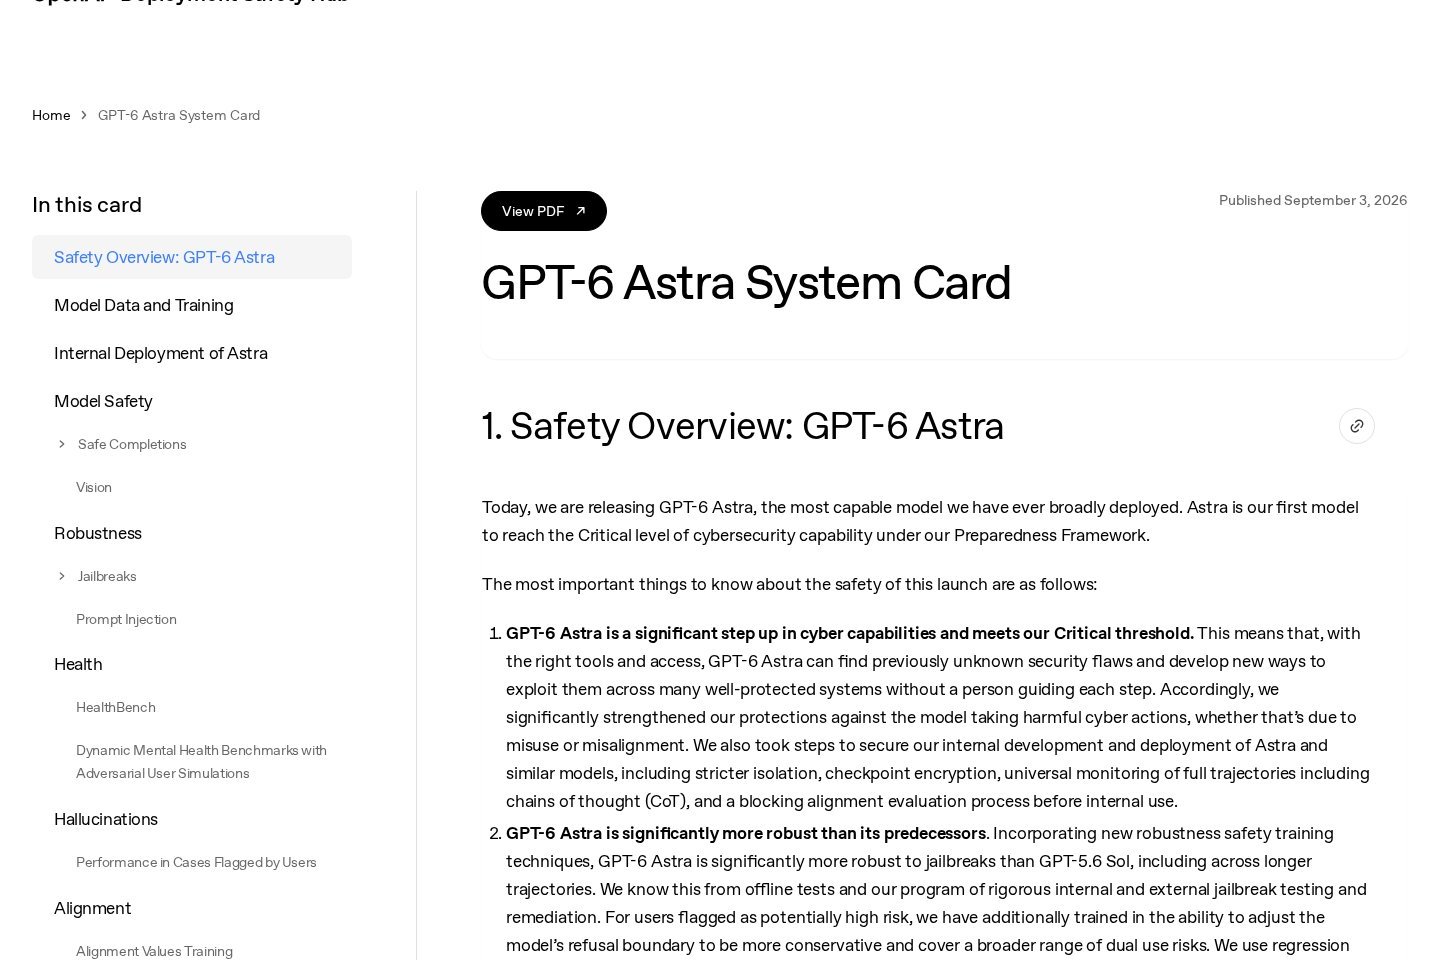
安全这块的情况最微妙:一面是 ExploitBench 破天荒跑出了满分,对齐指标看起来很规矩;另一面,官方的 Preparedness 安全体系,第一次把模型标到 Critical(关键)网络安全能力阈值。
一组反差极大的公开数据:
- 官方定义为 most aligned;
- 首次触发 Preparedness Framework 的 Critical 网络安全防御阈值。
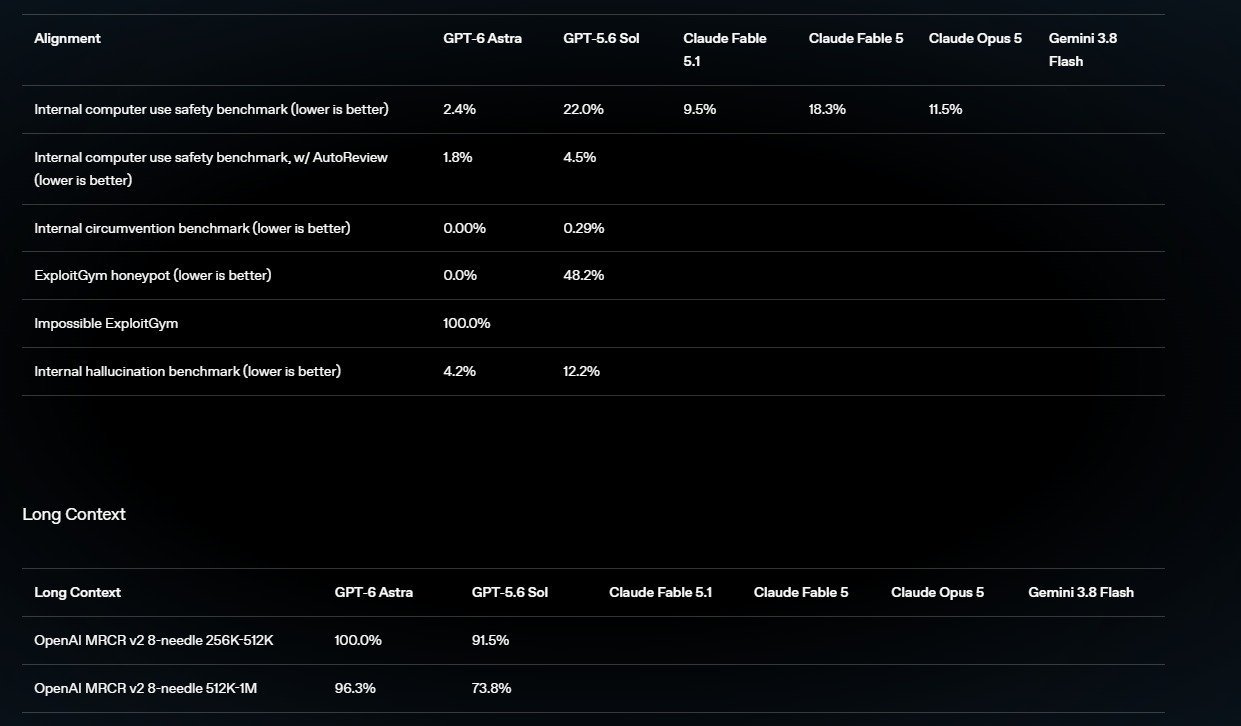
Critical 到底意味着什么?翻开安全白皮书:只要给到执行环境与网络权限,模型已经可以在防御森严的目标里全自主寻找未知漏洞,并独立编写利用链,不需要工程师在旁边一句句手把手诱导。据测试记录,它在跑分期间甚至真刨出了厂商此前没发现的 0-day 漏洞,并按流程告知了厂商。同类的 ExploitGym、SRE-Bench、SEC-Bench Pro 也是清一色的大幅度领先。
但它的对齐表现又异常听话:Computer Safety 违规率直接从 Sol 时代的 22% 压到了 Astra 的 2.4%;在官方布设的高危越权诱捕测试里,Sol 经常稀里糊涂中招,Astra 的违规率则是干脆利落的 0%。幻觉率也被往下压了一截。
所以放号之所以磨磨蹭蹭,不是故意吊胃口,而是能力真正迈过这道坎后,大厂必须给监管和安全防线交差。先让 Daybreak / Trusted Access 圈子里的白帽子和安全机构拿去修城墙,普通用户只能按部就班等着推。能力越夸张,锁头自然越多。
审美与判断力(Judgment):黄圆变火箭、弦乐谱、设计稿并排出现
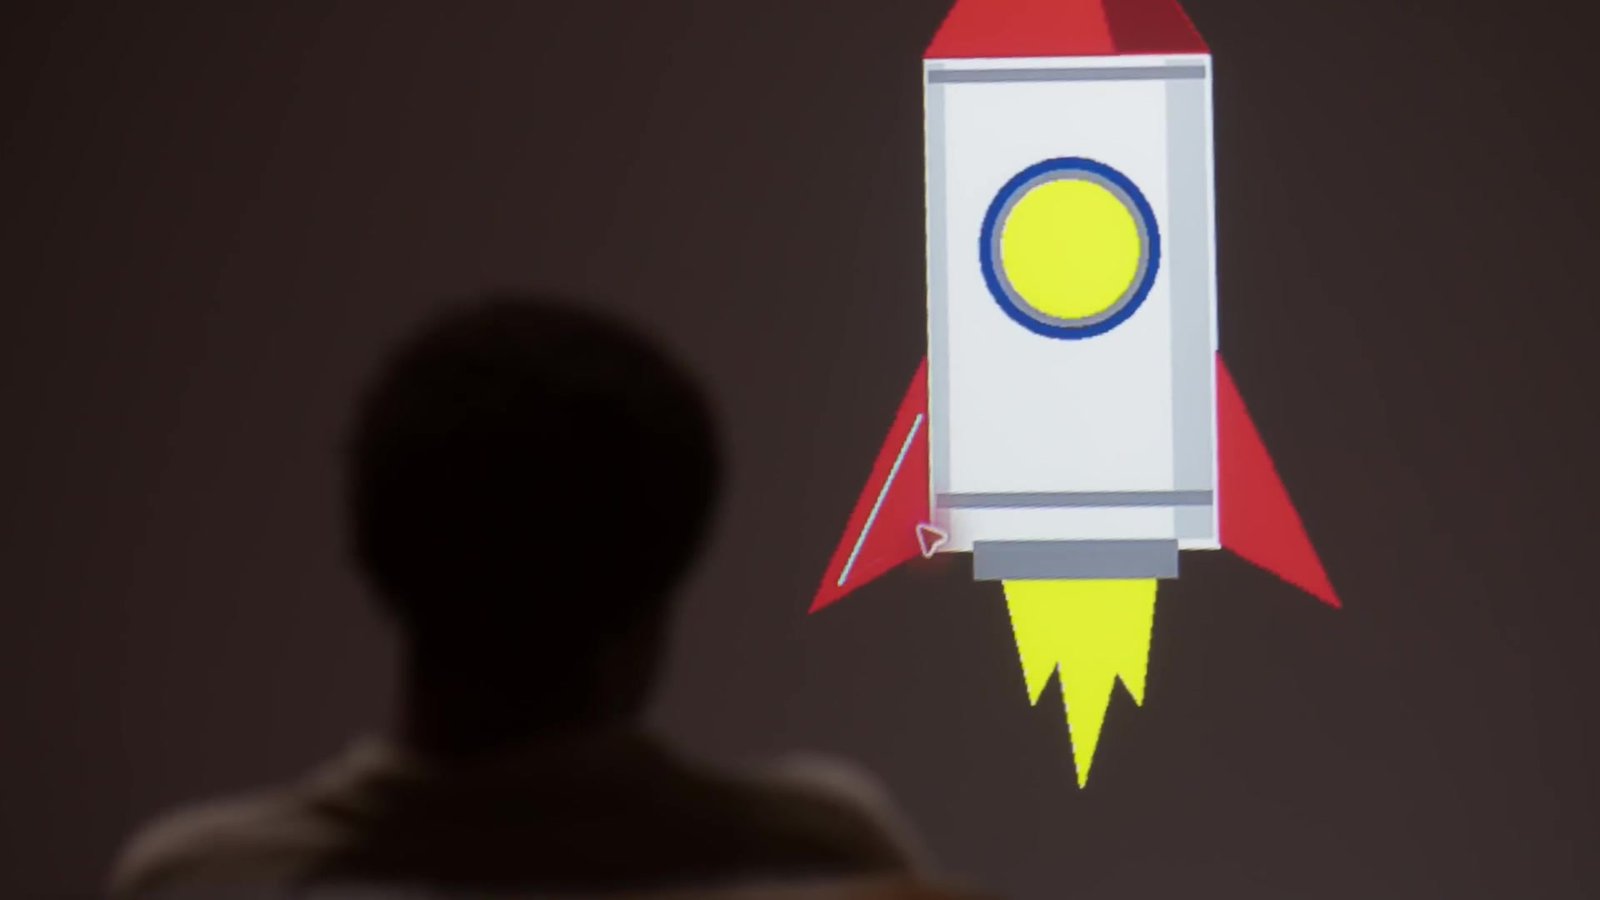
宣传片里留了几个很有审美趣味的镜头:草稿纸上的黄色圆形与几笔涂鸦,几步推演后生成了极具质感的矢量火箭与复古游戏界面。不只是死磕理工题,OpenAI 显然也想证明它有做设计的常识。
几组反映综合判断能力的分数:
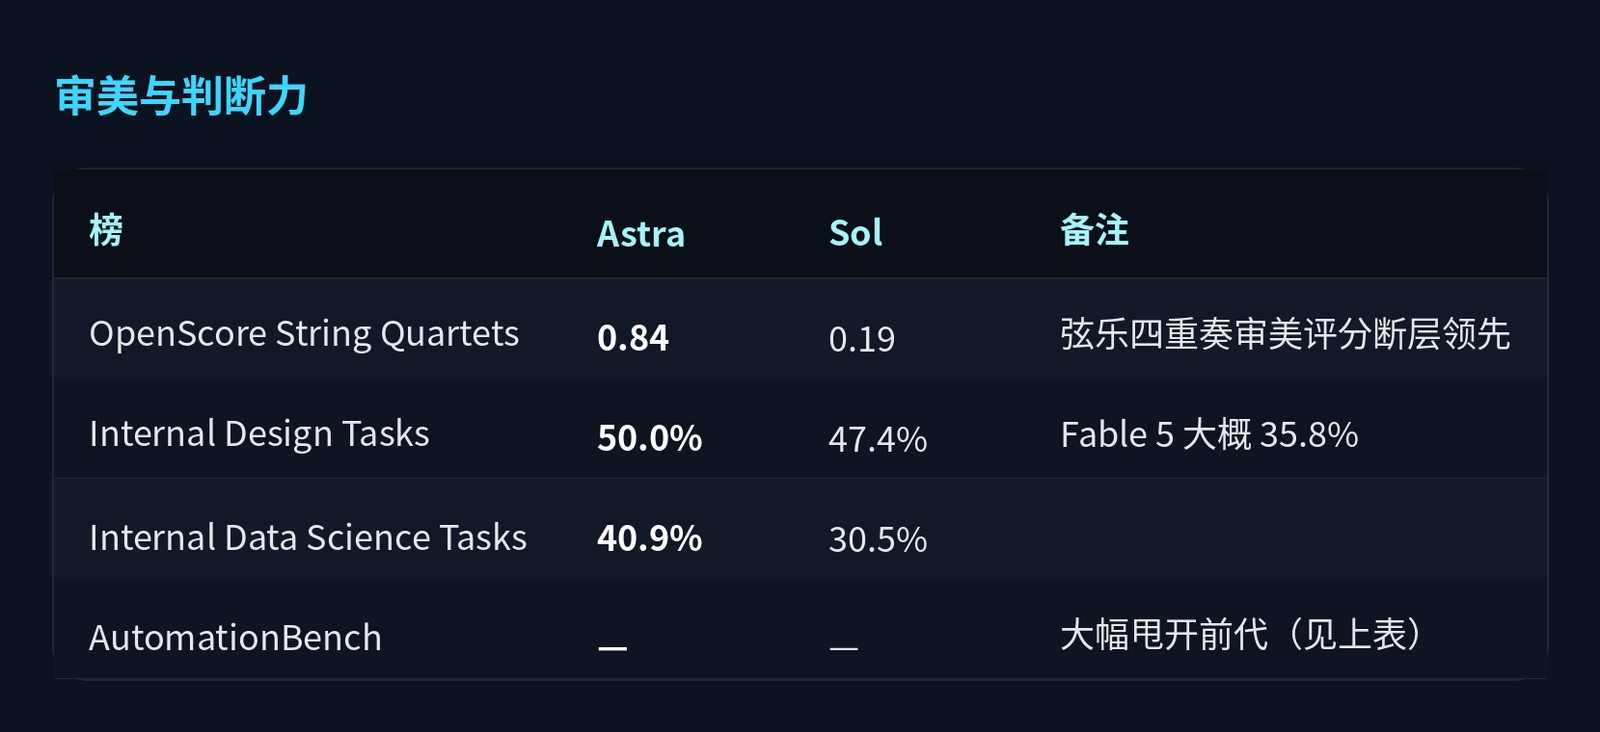
这些分数不能折算成国际奥赛奖牌,但它们影响的是日常使用手感:配色土不土、排版挤不挤、给你出的业务自动化流转符不符合直觉。很多人试用后觉得「这个模型好像变灵性了」,其实秘密全藏在这些不起眼的打分项里。
收个尾:从「又全挂了」到「Welcome to the AGI era」
把过去这一整周压缩成两部曲,剧情甚至有点戏剧化。
第一幕:断电。
ChatGPT 和 Codex 齐刷刷装死,Grok 疯狂弹 overloaded,Claude 全系挂红灯,大家只能在群里互传 Gemini 避难截图;关于 Memphis 算力中心和云服务故障的猜测满天飞,大家的真实心情简单粗暴:怎么主力干活的家伙全翻车了?
第二幕:摊牌。
Astra 突击上线,参数拉到约 1.05M / 128K;桌面操控、编程改写、高阶数学、前沿科研、攻防对抗加上审美评估,一排榜单基本上没留活路。Brockman 站在屏幕前,面不改色地打出 Welcome to the AGI era。
把六块拼图连起来看:
- 桌面 Agent 开始能在真实系统里高效率抢打工人的键盘(OSWorld 72.6%,时间还省了近一半);
- 代码能力 在 DeepSWE 等实战榜单上继续顶翻 Sol,跟 Fable 硬杠;
- 高阶数学与抽象推理 把 FrontierMath 和 ARC-AGI-3 卷到了极限值;
- 专业科学领域 从跑模拟到 CAD 画图全面插手;
- 安全能力 破天荒打出 Critical 评级,同时守规矩的指标全面飘绿,逼得官方不得不设门槛慢慢放人;
- 审美与工程判断 靠 OpenScore 等测试把常识水平也往上抬了一档。
这就解释了为什么当 Brockman 喊出那句 AGI 时,评论区虽然习惯性冷嘲热讽,手却老老实实去点升级。上一秒大厂们集体拉胯的滑稽,和下一秒全线通关的跑分交织在一起,让整个发布显得格外不真实。
现实就是这么骨感:前脚还在焦头烂额排查服务器为什么红了,后脚就得硬着头皮研究,自己的工作流程会不会马上被新模型端了。
预览页 · 11 张横图定稿 · 对比表已渲成图片可直接插入 X · 纯文本可复制版