succeeded。这是提交内容快照,审阅本页不会创建草稿或发布。
版本、校验值与提交结构
{
  "intent_id": 1,
  "revision": 1,
  "status": "succeeded",
  "approved": true,
  "artifact_sha256": "0d71e500907c8debb7aee31fe428156c9739d9ff4dd99cb9cef458b5ce57acf9",
  "generated_at": "2026-09-07T05:08:05Z",
  "warning": null,
  "image_ids": [
    "2096827595191156736",
    "2096827605442052097",
    "2096827618968666112"
  ],
  "images": [
    {
      "media_id": "2096827595191156736",
      "file_sha256": "b2d1d154aeb143a7e626cd8b47686cd0fdb037225beb9c8ffb6dba5461b84926",
      "width": 2000,
      "height": 800,
      "expires_at": "2026-09-08T05:07:08+00:00"
    },
    {
      "media_id": "2096827605442052097",
      "file_sha256": "05f70635b537bb7375409070b1740faba59050696f0fe58fed33b16d11d5c38b",
      "width": 1672,
      "height": 941,
      "expires_at": "2026-09-08T05:07:11+00:00"
    },
    {
      "media_id": "2096827618968666112",
      "file_sha256": "e77ad0cc560576f07b9360a411b682c1af453f085ee9a5fa9d8f9d65a6769952",
      "width": 1672,
      "height": 941,
      "expires_at": "2026-09-08T05:07:13+00:00"
    }
  ],
  "payload_sha256": "3069997661903da503e0992d65bc818b109daec6e8625f7d068c5cff79f39670"
}
查看完整提交 JSON 封面 · 2000 × 800
X 自动化运营宝典:30 天实战涨粉 30K
特殊内容:请核对原始结构
{
  "data": {
    "markdown": "整套手册围绕一个明确的经营结果展开:把 30 天新增关注 30K 拆成定位、内容、分发、互动和复盘的一组可执行指标。"
  },
  "mutability": "mutable",
  "type": "markdown"
}特殊内容:请核对原始结构
{
  "data": {
    "markdown": "这篇文章直接交付 6 样东西:\n\n1. 一份账号定位模板:明确服务谁、解决什么问题、提供什么判断,以及不做什么。\n2. 一张信源路由表:知道什么时候用 AI HOT、SoPilot、TikHub、X 官方 API 和原始来源。\n3. 一张选题决策卡:把读者任务、证据、形式、成本、时效和淘汰理由放在一起。\n4. 一张 30 天执行表:每天做什么、Agent 交付什么、用什么标准判断通过。\n5. 一份 Agent 交接模板:研究、写作、编辑和复盘分别读什么、输出什么、不能做什么。\n6. 一套复盘口径:怎样看曝光、收藏、关注、有效回复和转化,怎样避免把缺失数据当成零。\n\n你可以把后文的模板直接交给自己的 Agent,让它先审计项目,再按证据落地。本文不交付一个“自动发帖按钮”,而是交付一条从定位到复盘的可执行运营链。\n\n先把这张启动卡填完,再让 Agent 工作:\n\n```text\n账号:\n期初关注数(日期):\n30天目标净增关注:\n目标读者:\n账号承诺:\n内容方向:\n明确不做:\n可用信源:\n可读取指标:\n可用预算与期限:\n允许的动作:研究 / 写稿 / 配图 / 创建草稿 / 发布(逐项填写)\n最终需要我确认的动作:\n```\n\n启动卡不是形式。没有期初关注数,就不能计算净增;没有可读取指标,就不能把目标拆成转化率;没有动作授权,Agent 只能停在待审队列。\n\n很多人说要做 X 自动化,第一反应是:找一个抓热点的接口,接一个写稿模型,再加一个定时发布脚本。\n\n这能让你更快地产生内容,也能让你更快地产生重复、错误和没人负责的状态。\n\n真正的 X 自动化运营,最后一步才是发帖。前面至少还有六件事:你服务谁、每天看什么信息、哪些题值得做、事实是否站得住、稿子有没有被独立检查,以及发出去之后如何知道下一轮该改什么。\n\n我现在更愿意把账号看成一套内容操作系统。API、脚本和 Agent 都只是零件;系统的任务,是让判断、生产、分发和复盘能够持续接上。\n\n这套系统可以画成七层:定位、情报、决策、生产、分发、观测、学习。"
  },
  "mutability": "mutable",
  "type": "markdown"
}
特殊内容:请核对原始结构
{
"data": {
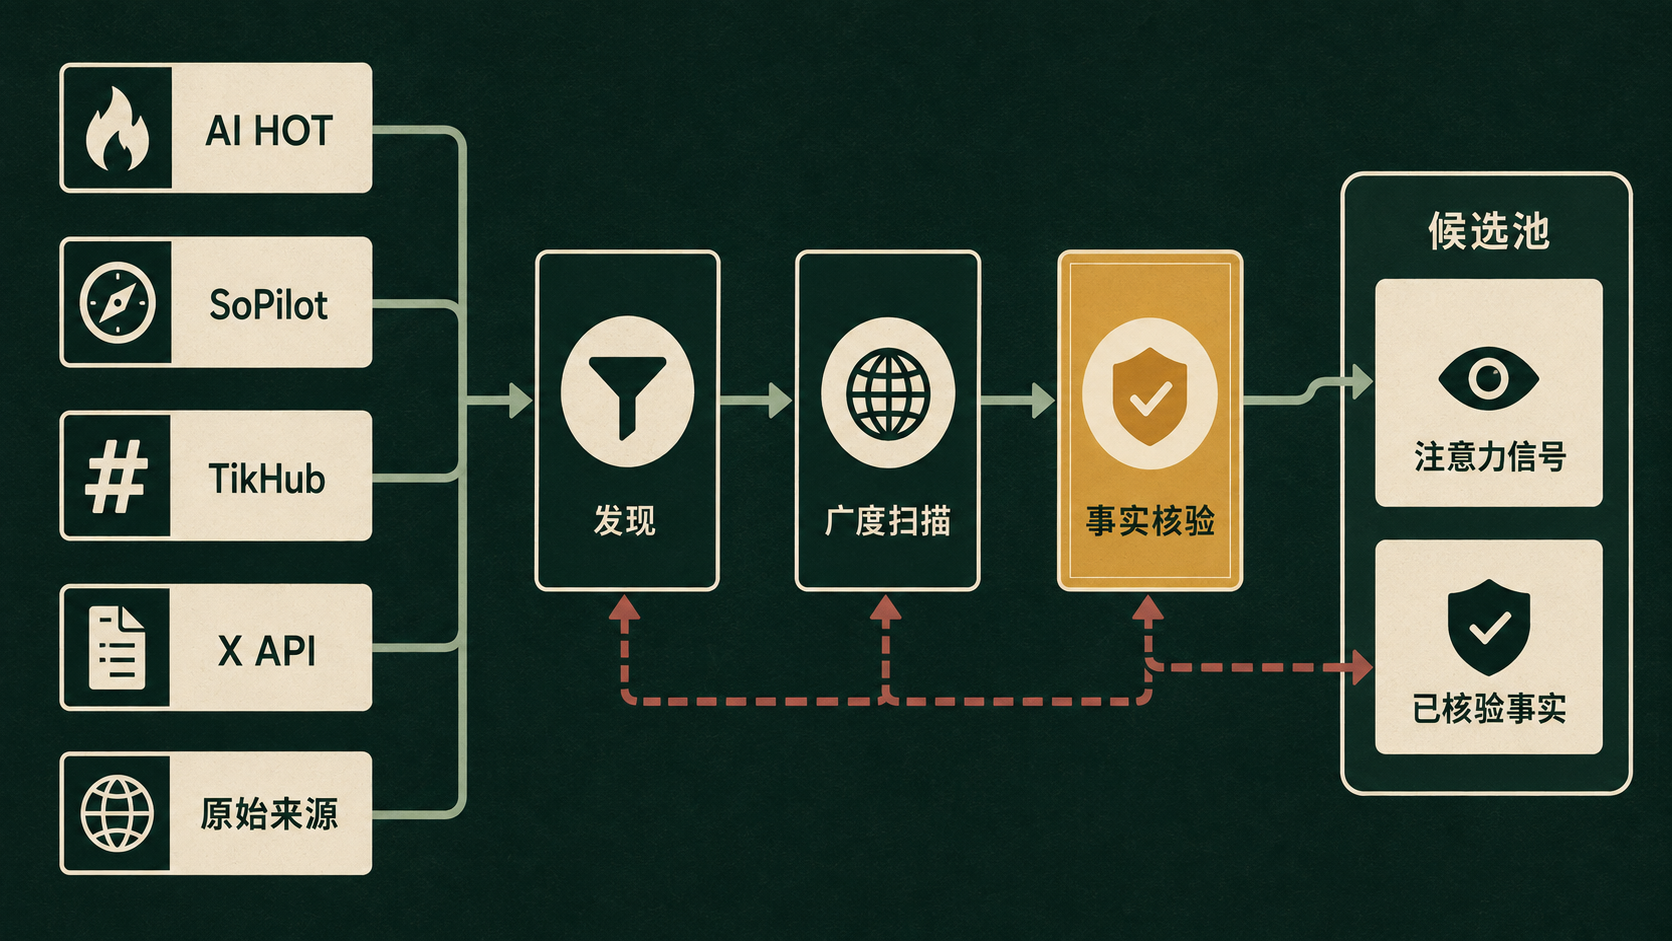
"markdown": "七层的输入和失败去向固定如下:\n\n| 层 | 输入 | 输出 | 不通过时回到哪里 |\n| --- | --- | --- | --- |\n| 定位 | 受众、承诺、边界 | 定位版本 | 回到用户决定 |\n| 情报 | 发现信号、公开来源 | 带时间和来源的事实材料 | 回到补源或标未知 |\n| 决策 | 事实材料、历史内容、读者任务 | 候选卡和淘汰理由 | 回到情报或暂缓 |\n| 生产 | 候选卡、事实包、结构 | 版本化稿件和视觉 | 回到研究或改稿 |\n| 分发 | 已审稿件、授权、媒体 | 待审草稿或发布回执 | 回到人工确认 |\n| 观测 | 公开身份、指标、评论 | 节点报告和需求样本 | 回到补回读,不填零 |\n| 学习 | 节点报告、反证、实验 | proposed 建议 | 回到人工接受或继续采样 |\n\n状态管理贯穿这七层:每个输入、输出、版本、授权和失败都留下唯一记录。它不是第八层,也不应该被某一个 Agent 私自修改。\n\n当前这套系统的证据状态也要单独写清楚:\n\n| 状态 | 已知内容 |\n| --- | --- |\n| 已完成验证 | SQLite 账本、来源去重与溯源、选题队列、长短稿生产、独立编辑、预算闸门、回执防重、任务恢复、只读审阅页 |\n| 已实现但持续运行待验 | 免费来源定时采集、跨周期续接、X 只读回采、模型周期调度、评论建议交接 |\n| 增长效果未验证 | 30 天净增 30K、单条内容带来的关注、收藏与转化、连续 7 天策略飞轮 |\n\n这张表让读者知道哪些可以直接照着搭,哪些还需要自己的账号跑出证据。\n\n## 第一层:定位不是简介,是最高约束\n\n定位不是写在主页上的一句漂亮话,而是每一个 Agent 都必须读到的边界。\n\n我们给账号定的方向是:帮助已经在用 AI 做事的中文个人和小团队,选对工具、做成任务、判断商业机会,把判断依据和可复用方案一起交付。\n\n这句话会约束后面所有事情:\n\n- 发现一个热点,要问它是否改变了读者的工具选择、任务执行或商业判断。\n- 写一篇文章,要交付判断依据或可复用方案,而不是只复述新闻。\n- 做一条短帖,也要先提供一项独立价值;需要互动时,只问一个具体问题。\n- 定位可以扩展,但不能被模型根据单篇数据偷偷改掉。\n\n没有这一层,自动化越强,账号越容易变成什么都讲、什么都像、什么都无法积累的内容流水线。\n\n## 第二层:情报不是把所有东西搬回来\n\n不同来源承担不同任务。\n\nAI HOT 和 SoPilot 负责发现行业变化和传播信号。TikHub 负责公开市场广度:扫对标账号、热帖、关键词、评论和趋势。X 官方 API 负责自己的账号、关键帖子、发布时间和指标回读,也负责所有写操作。官网、原帖、仓库和官方文档负责事实核验。\n\n这四类来源不能互相替代。一个热榜摘要可以告诉你“有人在讨论”,不能证明产品能力;TikHub 返回一百条转述,也不能算一百个独立案例;X 的指标可以告诉你发生了什么,不能单独告诉你为什么发生。\n\n因此情报层要保存的不只是标题,还要保存原始 URL、发布时间、采集时间、来源类型、共同原始事件、快照和核验状态。\n\n| 你要回答的问题 | 先用什么 | 再用什么 | 交付物 |\n| --- | --- | --- | --- |\n| 今天有什么新变化 | AI HOT / SoPilot | 原帖或官网 | 候选信号 |\n| 哪些账号和帖子值得追 | TikHub | X 官方关键核验 | 市场样本 |\n| 这条内容到底说了什么 | 原帖、仓库、官方文档 | 必要时 X 回读 | 事实原子 |\n| 我们自己的内容发生了什么 | X 官方 API | 原文和时间线 | 发布与指标快照 |\n\n这张路由表是本方案的工作分工,不是工具的固有属性。每次交给 Agent 时,还要注明当前接口是否已接入、是否需要授权、失败后回到哪一步。"
},
"mutability": "mutable",
"type": "markdown"
} 03-flow-source-routing · 1672 × 941
特殊内容:请核对原始结构
{
"data": {
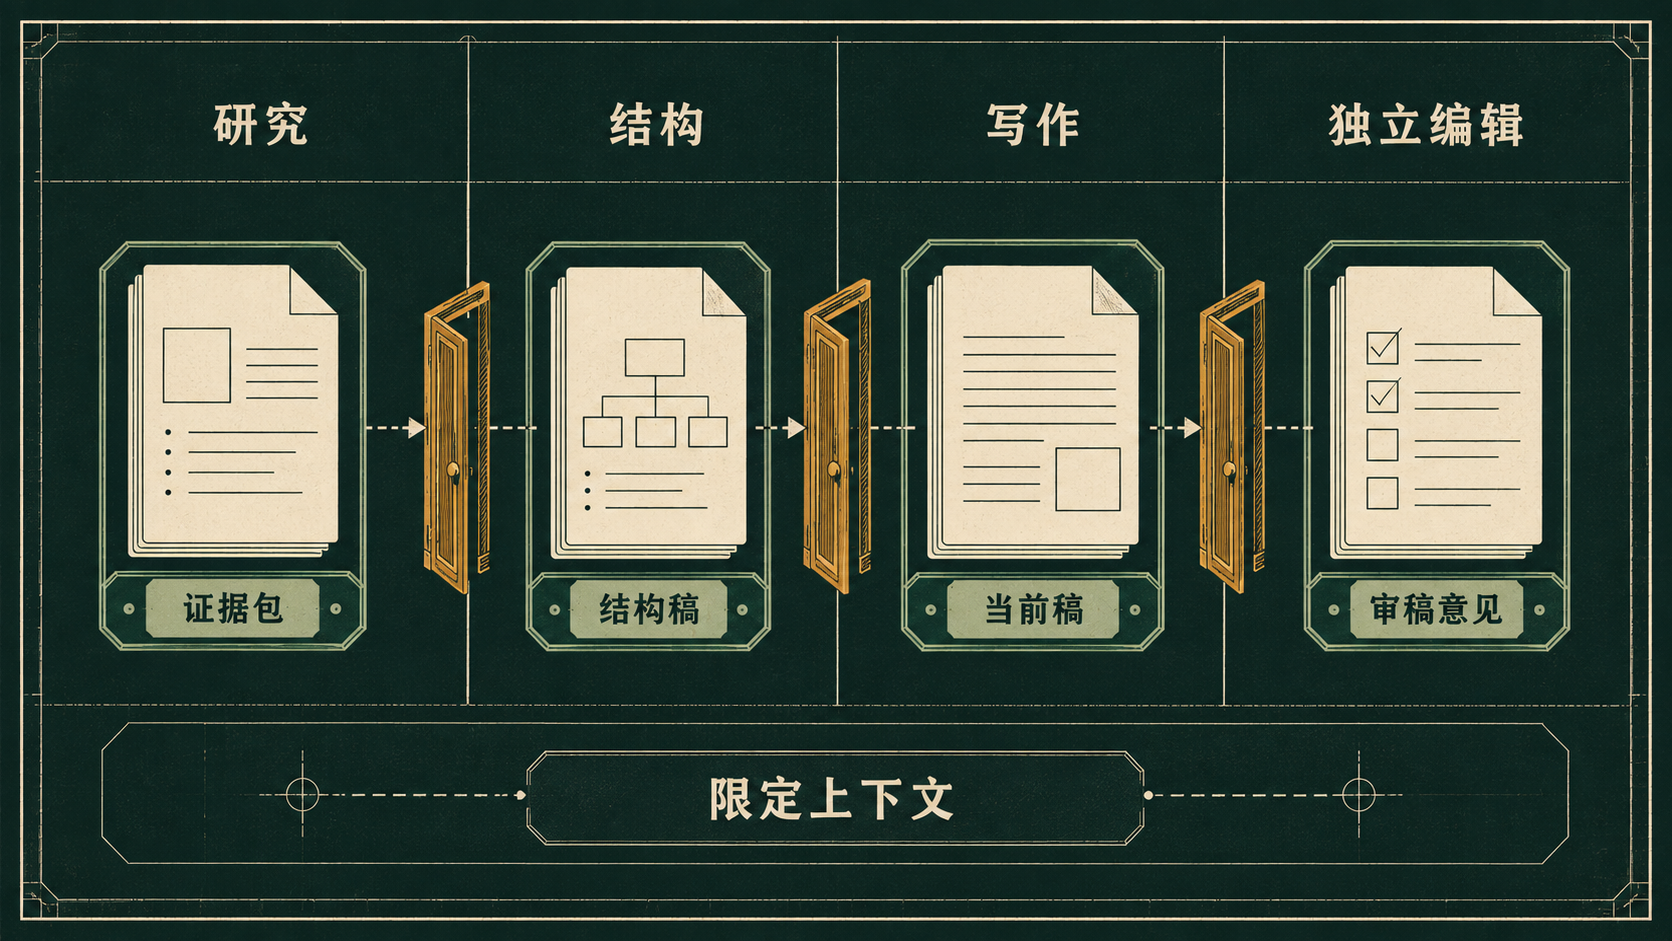
"markdown": "## 第三层:选题是决策层,不是热点排序\n\n从情报到选题,中间必须有一层判断。\n\n我们现在把候选放进六个方向:产品与能力、创作与分发、商业路径、成本与选择、工作与学习、行业与平台变化。\n\n每一个候选都要回答:\n\n1. 它服务哪个读者任务?\n2. 读者读完会改变什么判断?\n3. 它和已经发过的内容有什么不同?\n4. 适合短帖、长文、串文还是演示?\n5. 事实成熟到什么程度?\n6. 制作成本和失效条件是什么?\n\n选题还要留下淘汰理由。否则第二天同一个热点换个标题又会回来。\n\n可直接复制的选题卡:\n\n```text\n标题 / 核心命题:\n唯一产品或路径锚点:\n目标读者正在完成的任务:\n读者读完会改变什么判断:\n原始来源与日期:\n支持主张的原文摘录:\n最大反方或反证:\n与已发内容的差异:\n推荐形式与理由:\n制作成本估计 / 未知项:\n失效条件与复评日期:\n本文明确不写:\n淘汰或暂缓理由:\n```\n\n真正有用的候选,不是“某模型最近很火”,而是“某类人现在遇到一个具体问题,而一组新证据迫使我们重新判断它”。\n\n## 第四层:生产层要让 Agent 交接,而不是共享一段聊天记录\n\n生产可以拆成四个角色:研究、写作、独立编辑和运营负责人。\n\n研究 Agent 只读本篇相关来源,输出事实原子、逐字摘录、归因和未解决项。写作 Agent 只读定位、本篇 brief、事实包、结构和必要的读者需求。独立编辑只看当前稿、冻结结构和证据版本,检查标题兑现、论证、事实、互动目标和交付完整性。运营负责人决定是否采纳意见,并把决定写回系统。\n\n每个角色都不应该读取整个 Wiki 或全部聊天历史。上下文越大,边界越模糊;真正需要的是限定交接包。"
},
"mutability": "mutable",
"type": "markdown"
} 04-process-agent-handoff · 1672 × 941
特殊内容:请核对原始结构
{
  "data": {
    "markdown": "长文和短帖也不应共用同一套完成标准。短帖先交付一个判断,必要时收集一个具体经验;长文要完成现象、证据、机制、边界和行动的完整链条。\n\n| 角色 | 只读取 | 输出 | 不能做什么 |\n| --- | --- | --- | --- |\n| 研究 Agent | 本篇来源和定位 | 事实原子、摘录、归因、未解决项 | 不写成稿、不发布 |\n| 结构 Agent | 事实包、历史差异、读者任务 | 章节职责、论证顺序、验收条件 | 不补造事实 |\n| 写作 Agent | 已通过结构、事实包、当前需求 | 一个版本化稿件 | 不改变定位、不代替用户经历 |\n| 独立编辑 | 唯一当前稿、冻结结构、事实包 | 通过、修改或补证意见 | 不继承写作上下文、不直接发布 |\n| 运营负责人 | 市场包、编辑意见、指标报告 | 采纳理由、排期和下一步 | 不把缺失数据写成结论 |\n\n## 第五层:分发层就是流量运营能力\n\n流量不是系统外面的结果,它本身就是运营能力的一部分。\n\n这层包括:发现注意力、标题和开头包装、形式选择、发布时间、互动设计、获得有效曝光、沉淀关注,以及把读者导向收藏、信任和后续行动。\n\n自动化可以帮助比较标题、安排排期、记录版本和准备草稿,但不能把一条未经批准的稿件直接变成公开事实。\n\n每一次 Article 草稿都要绑定正文版本、图片文件哈希、账号、授权和请求身份。Article ID 和公开 Post ID 必须分开保存。超时或结果不明时,先查证,不重复创建。\n\n## 状态管理:贯穿七层的基础设施\n\n系统感最容易被忽略的部分,是状态。\n\n我们用 SQLite 保存账号、来源、候选、brief、稿件、任务、发布、指标和学习记录;Markdown 是给人看的研究视图;原始快照是证据层。\n\n一条内容有自己的内部 ID,稿件有不可覆盖的版本,任务有幂等键和租约,外部请求有预算预占和回执。模型进程中途退出时,系统会先判断它是否真的完成;有完整回执才能回填业务,不能因为“模型调用成功”就假设研究、写稿或审稿已经完成。\n\n这也是为什么自动化系统不能只靠一个 cron 加一个 prompt。真正要处理的是:任务做到一半怎么办、网络超时怎么办、资料在模型运行期间变了怎么办、一个周期结束了但下一步还没做怎么办。"
  },
  "mutability": "mutable",
  "type": "markdown"
}
特殊内容:请核对原始结构
{
  "data": {
    "markdown": "## 第六层:观测让流量反馈可用\n\n发布之后,至少要看 24 小时、72 小时和 7 天三个窗口。但指标缺失不能填零,文章的公开帖指标也不能被写成全文阅读或完读。\n\n如果要比较,至少要比较同账号、同形式、相近年龄、同流量类型和同来源口径的内容;样本不足,就只记录“证据不足”。\n\n评论也不能只看数量。真正有价值的是:读者在做什么任务,卡在哪个具体障碍。模型可以先提出评论分类建议,但必须保留原文摘录,且经过人工确认后才能进入需求池。\n\n## 第七层:学习让反馈回到下一轮判断\n\n最后,系统可以根据报告生成待审学习建议:例如“目前缺少公开身份和发布时间,暂时不能把传播结果归因到选题”;或者“已有少量数据,继续积累同形式样本,再判断标题和互动方式”。建议进入 proposed 状态,不能自动改变定位。\n\n这才是飞轮:\n\n定位 → 情报 → 判断 → 生产 → 分发 → 观测 → 学习 → 下一轮定位约束下的判断。\n\n## 目标拆解:30 天涨粉 30K\n\n30K 只能先当作一个待验证目标,不能当作这套系统已经兑现的成绩。真正要拆的是:每周需要多少有效曝光、多少主页访问、多少关注转化、多少收藏和有效回复,以及每天能稳定生产多少内容。\n\n第 1—7 天建立定位、历史内容、信源和期初关注基线,确认读者为什么要关注这个账号。第 8—14 天测试短帖开头、长文交付和互动问题,每天只改一个主要变量。第 15—21 天放大已经出现有效关注或收藏信号的方向,淘汰只带来空曝光的形式。第 22—28 天继续回填关注来源、主页访问、收藏、有效回复和后续行动。第 29 天只做数据缺口预审、来源核对和异常标记;第 30 天观察期结束后,统一按 UTC 记录期末关注数,计算净增、关注转化率、内容产能和数据缺口,再做下一周期决策,不临时追加一篇稿子来修饰结果。\n\n净增关注 = 期末关注数 − 期初关注数。30K意味着平均每天净增 1,000,只有在期初基线、有效曝光、主页访问和关注转化率都能取得时,才能继续拆成条件化测算。若没有有效信号,继续采样或降低放大范围;若样本不足,延长观察;若指标不可取得,标记未知并停止归因。"
  },
  "mutability": "mutable",
  "type": "markdown"
}
特殊内容:请核对原始结构
{
  "data": {
    "markdown": "这个过程里,流量就是运营能力的一部分,但单篇爆文不能外推成月度增长规律。账号基础、分发资格、内容供给和外部事件都会影响结果。缺少指标时记录为未知,不用估算数字把目标伪装成进展。\n\n## 最小版本怎么搭\n\n个人账号不需要一开始就建一个复杂的多 Agent 平台。最小版本只需要:\n\n- 一份定位和边界文件;\n- 一个来源和证据表;\n- 一个内容主记录和版本目录;\n- 一个有幂等键的任务队列;\n- 一个发布回填和指标复盘表。\n\n先让一条内容完整走通,再增加自动化。能自动完成的,是去重、哈希、状态、预算、文件校验、回执和排队;需要判断的,是选题、角度、表达、编辑意见和学习建议。\n\n## 收藏后直接执行:30 天操作表\n\n下面这张表不是阅读后的鸡汤,而是每天可以照着跑的最小循环。\n\n| 周期 | 运营负责人要完成 | Agent 交付 | 通过标准 |\n| --- | --- | --- | --- |\n| 第 1 周 | 定位、历史内容、信源和目标读者基线 | 定位审计、六方向候选、重复题清单 | 每个候选都有读者任务和淘汰理由 |\n| 第 2 周 | 安排短帖、长文和一次互动实验 | 事实包、结构稿、短帖版本、独立审稿 | 每条内容有独立价值,核心主张可回源 |\n| 第 3 周 | 根据有效关注、收藏和回复放大方向 | 新一轮候选、标题/开头变体、复盘报告 | 一次只改一个主要变量 |\n| 第 4 周 | 回填指标,决定保留、调整或暂停 | 学习建议、反证清单、下一轮排期 | 缺失数据保持未知,不把单篇爆文当规律 |\n| 第 29 天 | 预审数据缺口、来源和异常 | 缺口清单、待补回读任务 | 不提前计算期末净增 |\n| 第 30 天 | 记录期末关注数并完成复盘 | 净增、转化、内容产能和下一轮决策 | 统一 UTC 口径,缺失项标未知 |\n\n每天只需要跑一遍:\n\n1. 采集当天新增信号,标记发现源和原始来源。\n2. 选出不超过 3 个短帖或 1 篇长文候选,写清为什么现在做。\n3. 为每个候选建立事实包和“本文不写什么”。\n4. 让写作 Agent 只读本篇交接包,生成一个版本。\n5. 让独立编辑只审当前版本,提出通过、修改或补证意见。\n6. 用户确认后才准备草稿或发布,保存正文和图片哈希。\n7. 回填上一个窗口的数据,生成待审学习建议。\n\n## 直接复制给 Agent 的执行模板\n\n```text\n你现在是 X 账号运营审计 Agent。\n\n账号定位:{粘贴定位}\n本轮目标:{例如:30 天新增关注 30K,或先建立真实基线}\n内容方向:{方向列表}\n本轮时间范围:{开始日期}—{结束日期}\n\n只读取:定位文件、指定来源快照、已发布内容、当前稿件、指标报告。\n禁止读取:无关项目、凭据、私密评论和未授权目录。\n\n按以下顺序交付:\n1. 定位是否清楚,指出一条具体问题。\n2. 给出 3 个候选:读者任务、核心判断、证据、形式、成本、失效条件、与旧内容差异。\n3. 选出本轮优先项,并写出淘汰原因。\n4. 建立事实包:每条主张都给原文摘录、来源 URL、日期和不确定项。\n5. 只输出结构稿,交给新的编辑会话审查;通过后再写正文。不得伪造第一人称经历、数据或平台结果。\n6. 正文完成后把唯一当前稿、冻结结构和事实包交给另一个独立编辑。若只能由同一 Agent 自审,必须标记“自审,待独立复核”。\n7. 给出发布前检查清单;未经用户确认,不创建草稿、不发帖、不回复。\n8. 根据已有指标生成 proposed 学习建议;不能自动接受建议或改变账号定位。\n\n输出必须区分:公开事实、用户经历、推断、建议、未知项。\n如果证据不足,停在待补证,不用更强的标题掩盖缺口。\n```\n\n这份模板的作用,是把 Agent 从“写一篇看起来不错的文章”切换成“按账号系统完成一轮运营”。每日验收要求是留下可检查的判断、版本、证据和下一步;任何缺项都标记为未完成。"
  },
  "mutability": "mutable",
  "type": "markdown"
}
特殊内容:请核对原始结构
{
  "data": {
    "markdown": "如果一个 Agent 只能帮你批量生成文字,它只是写作工具;当它能在边界内读取资料、保留状态、接受编辑、回填结果,并把下一轮判断建立在真实证据上,才开始接近运营系统。"
  },
  "mutability": "mutable",
  "type": "markdown"
}